Vì sao AI viết được code nhưng chưa tự vận hành được hệ thống
Jad Naous (Grepr) và Martin Casado bàn về coding agent trong team 10 người, vì sao vận hành production khó hơn code, và AI debug bằng hypothesis (video đăng 16/10/2026).
✓ Đã duyệt độc lập · cập nhật 21/11/2026 · 59 min
1. Đoạn mở đầu: thế giới của AI và thế giới thật
Tập này của kênh a16z là cuộc trò chuyện giữa Martin Casado, General Partner của a16z, và Jad Naous, CEO của Grepr (theo phần mô tả của video đăng ngày 16/10/2026). Video mở bằng vài câu trích từ chính cuộc nói chuyện, ghép lại như một đoạn giới thiệu.
Martin nói (video đăng ngày 16/10/2026): thế giới mà AI sống trong đó hoàn toàn là digital, còn có thế giới thật, và hai thứ đó không nhất thiết giống nhau.
Jad nói (video đăng ngày 16/10/2026): khi anh và mọi người bắt đầu dùng AI cho coding, nó là autocomplete. Không ai thật sự biết có thể build phần mềm phức tạp bằng AI tới mức nào. Rồi về cơ bản nó vượt qua kỳ vọng, vì anh và mọi người đã có thể mô hình hoá ngày càng nhiều độ phức tạp trong các hệ thống.
Martin nói (video đăng ngày 16/10/2026): anh không biết operations (vận hành hệ thống) có bị giới hạn theo cùng một cách như vậy không. Dữ liệu để học cách build một hệ thống hiểu được toàn bộ operations thậm chí nằm ở đâu?
Jad đáp (video đăng ngày 16/10/2026): giả định của anh là chúng ta có toàn bộ dữ liệu. Câu hỏi, theo anh, có lẽ là về độ phức tạp, và về chuyện có thể lấy những thứ thuộc về vận hành mà Martin mô tả, rồi chuyển chúng thành thứ mà một AI có thể suy luận được, tới mức nào.
Martin nói (video đăng ngày 16/10/2026): bí mật không mấy hay ho, suốt một thời gian rất dài, của việc vận hành một distributed cluster là chỉ có con người quản lý nó. Anh hỏi: anh có nghĩ chúng ta đã tới lúc có thể dùng AI để vận hành một trong những service như vậy chưa? Jad bắt đầu trả lời: anh nghĩ là đã có đủ để có thể…
2. Martin giới thiệu Jad và chuyện "độ ngầu" thời cao học
Martin cảm ơn Jad đã tham gia podcast. Anh giới thiệu (video đăng ngày 16/10/2026): với những ai chưa biết, Jad là CEO của Grepr, và hai người cũng từng học cao học trong cùng một nhóm. Martin kể: lần đầu gặp Jad, nhóm có một sinh viên mới. Anh bước vào văn phòng và thấy một chiếc mũ bảo hiểm xe máy cùng một bao thuốc Marlboro. Anh nghĩ: anh chàng này chắc phải ngầu không tưởng. Vậy câu hỏi của anh là: tất cả độ ngầu đó đã đi đâu rồi?
Có tiếng nói: "Question number one." Martin nói tiếp (video đăng ngày 16/10/2026): để có bối cảnh, mời Jad giới thiệu nhanh về xuất thân. Với những ai đang nghe, theo Martin, Jad là một trong những người tư duy về hệ thống giỏi nhất mà anh biết, và anh rất thích nói chuyện với Jad. Hai người sẽ đi sâu vào engineering từ góc nhìn hệ thống, và AI đang tác động tới mọi người ra sao, đặc biệt là ở những thứ như operations. Nhưng để có nền, Martin mời Jad nói một chút về xuất thân.
Có tiếng đáp: "Sure." Jad nói (video đăng ngày 16/10/2026): Martin đã gặp anh vào một trong những lúc độ ngầu của anh lên đỉnh. Có tiếng đáp: "Yeah, you're pretty cool." Martin nói: xe máy và thuốc lá Marlboro. Anh nhớ mình đã nghĩ: trời, thuốc lá còn hợp pháp à? Nó lạc quẻ tới mức đó.
Jad kể (video đăng ngày 16/10/2026): anh nhớ một hôm Nick thấy anh hút thuốc bên ngoài Gates, nhìn anh và… Martin giải thích: Nick là người hướng dẫn (advisor) của hai người, còn Gates là tên toà nhà.
Martin kể thêm (video đăng ngày 16/10/2026): một trong những điều anh thích, Jad có nhớ một giáo sư (Martin gọi tên ông) không? Có tiếng đáp: "Of course." Martin nói: điều anh thích nhất ở vị giáo sư đó là ông hút thuốc; theo anh, ông là giáo sư duy nhất như vậy. Có tiếng nói thêm: "I just thought it was like great."
Jad nói rõ (video đăng ngày 16/10/2026): anh không còn hút thuốc nữa. Giờ anh đã quá già, quá trung niên cho chuyện đó.
3. Jad kể: Stanford, SHA-3, postdoc ở MIT và một startup đi quá sớm
Jad kể về xuất thân (video đăng ngày 16/10/2026): anh học ở Stanford cùng Martin. Martin lúc nào cũng là người anh phải ngước nhìn, kiểu: đây là người mình muốn trở thành khi lớn lên. Martin nói: anh bắt đầu sớm hơn Jad bốn năm. Jad nói tiếp: vậy là Martin đi trước anh bốn năm, tốt nghiệp trước anh một quãng khá xa, rồi đi thành lập Nicira.
Jad kể (video đăng ngày 16/10/2026): anh thì ở lại, làm thêm về OpenFlow, giúp build một loạt thứ ở phía hardware từ góc nhìn security. Một trong những project vui nhất anh làm ở đó là build bộ implementation SHA-3 đầu tiên trong số những bản mà người ta đang cân nhắc dùng. Anh build chúng trên hardware, để cho thấy chúng có chạy được hay không, cho một trong các project của luận án. Anh nói việc đó vui. Có tiếng đáp: "Yeah, yeah."
Jad kể tiếp: rồi sau một thời gian anh quyết định là thật ra anh không thích networking, vì nó chỉ là chuyển các bit từ chỗ này rồi đặt chúng vào chỗ khác. Có tiếng nói: "How hard can that be?" Martin nói thêm (video đăng ngày 16/10/2026): người ta phải đứng về một phía về mặt triết lý: hoặc nó sâu sắc, hoặc không. Hầu hết mọi người cho rằng nó không sâu. Còn anh nghĩ nó rất sâu.
Có tiếng nói: "I mean, there's something interesting about it." Jad nói (video đăng ngày 16/10/2026): nhưng rốt cuộc, với anh, nó không phải vậy. Martin nói: nó không hợp với anh. Có tiếng đáp: "Yeah."
Jad kể (video đăng ngày 16/10/2026): sau đó anh đi làm postdoc ở MIT với Nickolai Zeldovich, người theo anh cũng sâu sắc đáng kinh ngạc và cực kỳ thông minh. Có tiếng đáp: "Yeah, he's phenomenal." Jad kể: lúc đó anh làm một số việc về application security, rồi thành lập một công ty dựa trên một phần nghiên cứu anh làm cùng một nghiên cứu sinh PhD ở đó. Rốt cuộc, công nghệ đã đi quá sớm.
Có tiếng hỏi: "What was it?" Jad giải thích (video đăng ngày 16/10/2026): rốt cuộc rất nhiều phần công việc thực ra là của người nghiên cứu sinh đó. Luận án PhD của người đó là: nếu bạn bị tấn công và bị khai thác (exploit), liệu bạn có thể phục hồi bằng cách rollback trạng thái của toàn bộ thế giới liên quan tới ứng dụng đó, rồi chạy lại nó lên trên một phiên bản ứng dụng đã được vá, để gỡ bỏ exploit không? Và nhóm bắt đầu làm điều đó trong thế giới thật. Có tiếng nói: "And we're like, that sounds really hot."
Martin nói (video đăng ngày 16/10/2026): điều này thật ra khá liên quan tới chủ đề hôm nay. Có thể thật sự giới hạn (bound) được trạng thái của các hệ thống vận hành tới mức nào, điều mà anh cho là rất khó. Có tiếng đáp: "We almost got it working. Almost."
Martin nói (video đăng ngày 16/10/2026): anh cảm thấy với mọi ngành long tail, bạn thấy một chút tiến bộ, nhưng bạn đang tiệm cận (asymptoting). Rồi anh nói mình đang lạc đề, và mời Jad kể tiếp.
4. AppDynamics, a16z, Imply và câu hỏi về chi phí observability
Jad kể (video đăng ngày 16/10/2026): sau đó anh vào AppDynamics và ở đó khoảng ba năm rưỡi. Công ty đi từ khoảng 200 người lên 2.000 người, rồi được Cisco mua lại. Anh làm nhân viên Cisco đúng một ngày.
Jad kể tiếp (video đăng ngày 16/10/2026): rồi Martin rủ anh về làm cùng, làm cái nghề VC này. Anh hỏi lại: VC là gì? Anh là architect, anh làm mấy thứ engineering. Và Martin bảo: tuyệt, anh càng biết ít càng tốt. Jad nói đó đúng là nguyên văn lời Martin. Có tiếng đáp: "That's true." Jad kể: ngày đầu tiên anh bắt đầu ở đây, Martin bảo anh: chậm lại.
Martin giải thích (video đăng ngày 16/10/2026): những người chuyển từ một vai trò vận hành công ty (operating role) sang VC cần phải sắp xếp lại bộ não rất nhiều. Cũng giống như đi từ PhD sang vận hành công ty, nhân tiện: bạn phải gỡ bỏ những tổn thương não bộ (brain damage). Có tiếng nói: "This is what the real world is like." Có tiếng đáp: "I know."
Jad kể (video đăng ngày 16/10/2026): rồi anh ở a16z vài năm, làm nhiều việc cùng Martin, đó là một quãng thời gian rất vui, và anh làm việc với rất nhiều người giỏi ở đây; anh kể tên vài người, và có tiếng nhắc thêm một cái tên. Sau đó anh vào Imply với vai trò chief product officer, giúp họ build các team product và engineering, mở rộng từ khoảng 15 người lên hơn 90 người, trải khắp product, engineering, infosec và design.
Jad kể tiếp (video đăng ngày 16/10/2026): sau khoảng ba năm, mỗi mảng anh phụ trách đều đã có một người đứng đầu, và anh kiểu như ngồi đó, chỉ điều phối và họp cả ngày, và anh muốn đi làm việc khác. Anh rời đi, rồi bắt đầu nói chuyện với nhiều engineering leader về những vấn đề họ đang gặp và điều họ đang cố làm.
Jad kể (video đăng ngày 16/10/2026): lúc đó là năm 23. Anh hỏi họ: các bạn đang chi tiền vào đâu? Ai cũng trả lời: observability. Thật ra đầu tiên là infrastructure, rồi tới observability. Anh bắt đầu nhìn vào vấn đề đó, cố hiểu vì sao người ta nghĩ nó quá đắt. Hoá ra có vài điều. Thứ nhất, người ta đang chi cho observability khoảng từ 5 tới 20% số tiền họ chi cho infrastructure. Nhưng rốt cuộc, thứ họ thật sự muốn chi tiền vào là reliability; họ muốn mua reliability.
Martin chen vào một vế (video đăng ngày 16/10/2026): "…of spend, like predictability of spend" (khả năng dự đoán của khoản chi). Jad đáp: reliability của infrastructure và ứng dụng của họ. Có tiếng đáp: "I see, I see, I see."
5. Vì sao người ta thấy observability đắt, và Grepr ra đời thế nào
Jad giải thích (video đăng ngày 16/10/2026): vậy là họ đổ tiền vào observability như một thứ đại diện (proxy) cho reliability. Và suốt một thời gian dài, càng chi nhiều tiền thì càng có nhiều reliability. Nhưng khi kiến trúc thay đổi, chuyển sang microservices nhỏ hơn nhiều, tích hợp dọc (vertically integrated) hơn nhiều, lượng dữ liệu được thu thập ở mọi tầng phình ra, observability thâm nhập thị trường sâu hơn nhiều, và lượng dữ liệu bạn thu thập cùng chi phí observability thật sự bắt đầu tăng nhanh hơn số đơn vị chức năng (units of function) mà bạn tạo ra.
Theo Jad (video đăng ngày 16/10/2026), mức tăng biên của reliability trên mỗi đô la chi thêm cho observability cứ thế phẳng dần. Anh nói đó là lý do người ta nghĩ nó đắt, nhưng người ta vẫn sẵn lòng trả 5% tới 20% cho reliability.
Jad kể (video đăng ngày 16/10/2026): vậy câu hỏi là liệu có thể giải quyết vấn đề đó và đưa mức tăng biên của reliability trở lại, không nhất thiết bằng cách chi thêm tiền cho observability, mà bằng một cách nào khác. Suy nghĩ khi đó là: nếu xác định được đâu là signal, đâu là noise, liệu có thể lấy dữ liệu observability mà bạn đang thu thập, thứ mà tới lúc đó phần lớn là phần thừa và phần lớn là để bảo hiểm, rồi làm việc trích xuất thông tin ở phía upstream, làm bất cứ thứ gì cần làm ở upstream, để rốt cuộc giảm mạnh chi phí observability ở downstream không?
Theo Jad (video đăng ngày 16/10/2026), nếu trích được signal đó theo thời gian thực ở upstream thì, một, bạn giảm được chi phí, và hai, bạn có thể đưa nó vào các hệ thống khác và dùng nó để thúc đẩy các hoạt động reliability sau đó. Và vào thời điểm ấy, có một thứ gọi là AI đang xuất hiện. Anh và nhóm nghĩ: tuyệt, nếu mình nằm trong luồng dữ liệu và đang trích xuất signal, thì mình ở một vị trí chiến lược để đưa nó cho bất cứ thứ gì sẽ tới trong tương lai, vì điều đó sẽ cần thiết.
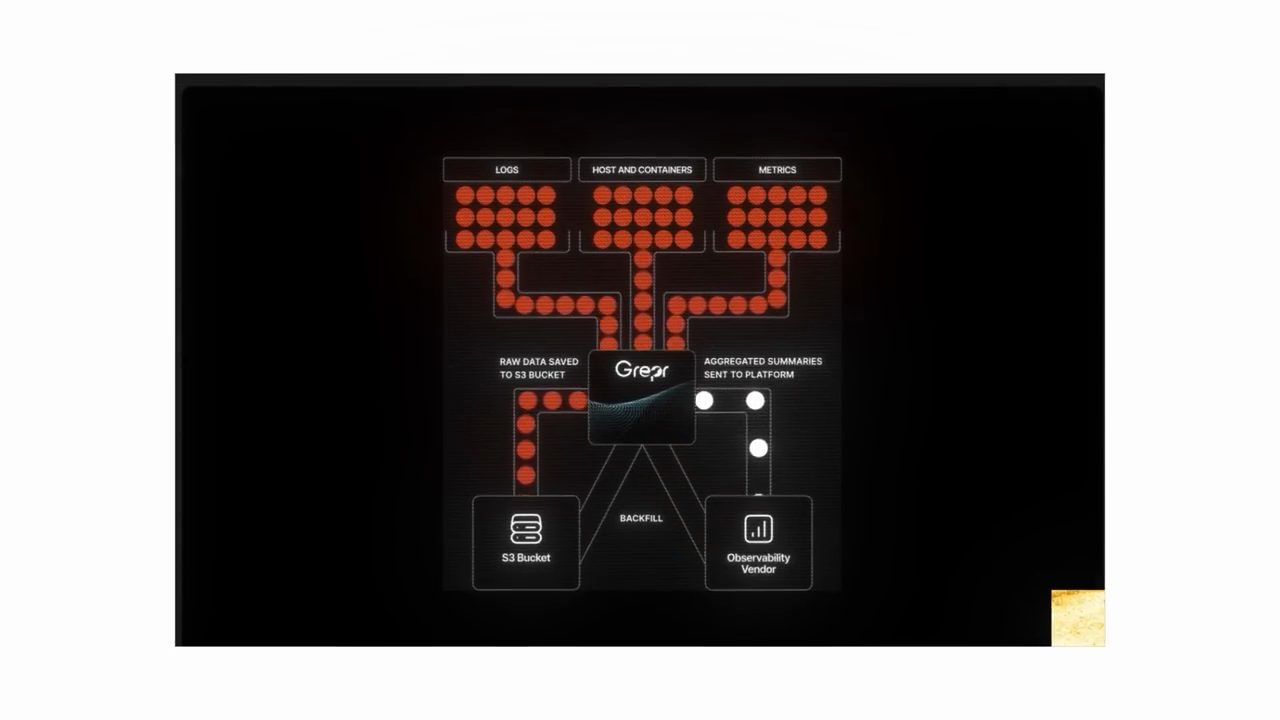
Jad nói (video đăng ngày 16/10/2026): đó là thứ anh và nhóm đã build. Grepr giúp các công ty; nhóm bắt đầu bằng việc giúp họ giảm mạnh chi tiêu cho telemetry. Bạn đặt Grepr vào luồng dữ liệu, kiểu plug and play, cho dữ liệu đi qua, và theo lời Jad, giảm chi phí 90%. Và giờ nhóm đang build lớp thứ hai, nơi các signal đó được đưa vào lớp AI, thứ đang đi troubleshoot, tìm ra khi nào mọi thứ trục trặc và sửa chúng.
6. AI thay đổi việc lập trình: từ autocomplete tới harness
Martin nói (video đăng ngày 16/10/2026): anh muốn nghe Jad kể về trải nghiệm của mình về cách AI đang thay đổi việc phát triển phần mềm nói chung. Theo Martin, nhiều người có thể hỏi câu này và nhiều người trả lời, nhưng anh cảm thấy Jad là kiểu "engineer của các engineer": từng làm architect, từng điều hành product, điều hành các team engineering. Anh hỏi: công ty Jad bây giờ lớn cỡ nào, bao nhiêu người? Jad đáp: 10 người. Có tiếng đáp: "Yeah."
Martin nói tiếp (video đăng ngày 16/10/2026): vậy là Jad đang build rất nhiều phần mềm với một team tương đối hiệu quả. Anh mời Jad phác hoạ ở mức tổng quan: nếu bạn là một senior engineer như Jad, có kinh nghiệm kiến trúc, thì theo Jad người ta đang thấy mức tăng năng suất nào; Jad dùng AI ra sao, Jad thật sự thấy mức tăng nào, stack là gì, quy trình là gì, và Jad nghĩ về nó thế nào.
Jad đề nghị kể theo góc nhìn lịch sử về chuyện điều hành một team (video đăng ngày 16/10/2026). Khi anh và nhóm mới bắt đầu, AI vẫn còn kiểu autocomplete. Anh nhớ lúc đó nhóm dùng Copilot trong IntelliJ, và cả nhóm kiểu: trời ơi, nhìn kìa, nó autocomplete mấy cái test này. Rồi lại kiểu: ừ, nhưng nó chỉ là autocomplete thôi. Và mọi thứ bắt đầu tiến hoá rất nhanh.
Jad kể (video đăng ngày 16/10/2026): điều anh để ý là những engineer thật sự giỏi bằng cách nào đó đưa được nó vào workflow của họ theo một cách mà AI bắt đầu huấn luyện họ. Martin nói: "Oh, interesting." Jad nói rõ: về cách nói chuyện với nó, cách khai thác tốt nhất từ nó. Anh vừa bắt đầu "và điều anh để ý…" thì Martin hỏi ngang.
Martin hỏi (video đăng ngày 16/10/2026): nhân tiện, bên lề một chút, Jad có nghĩ điều đó phụ thuộc vào model không? Bạn học cách dùng AI nói chung, hay bạn trở nên hiệu quả với một model cụ thể?
Jad trả lời (video đăng ngày 16/10/2026): anh nghĩ có những sắc thái riêng mà các model khác nhau mang lại; anh chắc là nhìn các tweet của Martin thì Martin cũng đã… Có những sắc thái, nhưng có một cách để làm việc với AI. Và anh nghĩ cũng có một cách để làm việc với các harness khác nhau. Ví dụ, nhóm đã thử dùng OpenCode hay các harness khác, hoặc dùng Codex so với Claude Code. Theo Jad, mỗi cái có cách quản lý context khác nhau, cách suy nghĩ qua vấn đề khác nhau, hoặc khác nhau ở chuyện khi nào spin up đúng sub-agent và bảo nó điều gì, kiểu prompt nào.
Jad lấy ví dụ (video đăng ngày 16/10/2026): với Claude Code, anh thấy nếu anh không dặn nó đừng spin up 20 agent Fable để làm research cơ bản, nó sẽ đi spin up 20 agent Fable để làm research và đốt hết token của bạn. Nên nhiều thứ kiểu này, bạn bắt đầu học về harness và về model, cách chúng tương tác với nhau, rồi cách chúng có thể tương tác với phần còn lại của thế giới.
Jad nói anh đang lạc đề (video đăng ngày 16/10/2026). Theo anh, điều anh bắt đầu để ý là một số người thích nghi và học, làm theo cách đó, còn những người khác không thích nghi được bằng. Rồi khi nhóm bắt đầu tuyển thêm người, khoảng cách giữa những engineer ở mức ổn và những engineer thật sự giỏi cứ thế nhân lên 10 lần.
7. Khoảng cách giữa engineer ổn và engineer thật giỏi
Martin hỏi (video đăng ngày 16/10/2026): có đoán trước được ai sẽ giỏi không? Có phải engineer giỏi thì giỏi hơn, còn engineer kém thì không? Có tiếng nói: "Or was it really okay?" Có tiếng đáp: "Yeah." Martin nói tiếp: vậy nếu bạn là một engineer giỏi, bạn chỉ thành một engineer giỏi hơn; chứ không phải là có những engineer kém bỗng dưng trở thành engineer giỏi.
Có tiếng đáp: "No." Có tiếng nói: "Okay." Jad nói (video đăng ngày 16/10/2026): không, không. Lúc nào rốt cuộc cũng là bạn phải thật sự hiểu cái setup. Vì bộ não của bạn xử lý được càng nhiều độ phức tạp, bạn càng chia nhỏ được các task và giao chúng đi.
Martin nói (video đăng ngày 16/10/2026): anh nghĩ đây có thể thật sự là một quan điểm không theo số đông (non-consensus); thỉnh thoảng anh có nghe, nhưng cái ý là những engineer giỏi hơn thì giỏi hơn rất nhiều. Anh nói: Jad thấy điều này khá đúng ở mọi nơi.
Jad đáp (video đăng ngày 16/10/2026): team anh vẫn còn nhỏ, nhóm chưa làm điều này trên quy mô 100 người. Có tiếng đáp: "Yeah." Theo kinh nghiệm của Jad, với những thứ nhóm làm, điều đó đúng, vì nhóm build distributed systems và distributed algorithms. Và bộ não của bạn phải xử lý độ phức tạp, vì AI không làm việc đó. Có tiếng đáp: "Right. Yeah."
Jad nói (video đăng ngày 16/10/2026): với những bài toán nhóm giải, không model nào thật sự suy nghĩ thấu được những thứ nhóm làm. Ví dụ, nhóm có một query translation layer; hai người vừa nói về query optimization. Bạn phải thật sự hiểu semantics của query và cách đi tới semantics của query, rồi giải thích nó cho model, rồi để model đi build translation layer, chẳng hạn.
8. Syntax và semantics theo cách mỗi người giải thích
Martin hỏi (video đăng ngày 16/10/2026): với những người đang nghe mà có thể không đi sâu vào khoa học máy tính, Jad muốn nói gì khi dùng chữ semantics?
Jad giải thích (video đăng ngày 16/10/2026): semantics thật ra là ý nghĩa của sự vật. Semantics của chữ "dog" là con vật đi bằng bốn chân và biết sủa, còn syntax là việc nó chỉ là một từ gồm ba chữ cái khác nhau; hình dạng của từ đó khác đi, và hình dạng đó có thể khác nhau giữa các từ khác nhau. Nhưng các từ khác nhau cũng có thể mang cùng một nghĩa, nên chúng có thể có cùng semantics nhưng khác syntax. Một con chó (dog) và một con chó con (puppy) có thể có semantics hơi khác nhau, chúng cùng chỉ một thứ, nhưng đủ gần nhau.
Martin nói (video đăng ngày 16/10/2026): cách anh mô tả, rất đơn giản, cho riêng khoa học máy tính, là syntax giống như những ký tự bạn gõ, còn semantics là điều máy thật sự làm. Nó kiểu như các tính chất runtime thật sự của hệ thống.
Jad nói (video đăng ngày 16/10/2026): vậy là Martin học khoa học máy tính, còn anh học kỹ thuật điện (electrical engineering). Martin nói: Jad trở thành nhà khoa học máy tính, còn anh trở thành VC. Có tiếng nói: "That's the problem." Có tiếng đáp: "I see."
Martin nói tiếp (video đăng ngày 16/10/2026): dù sao, anh chỉ muốn những người đang nghe hiểu rằng có syntax thật sự, là việc viết code; khi nói về syntax, bạn chỉ đang nói về bản thân đoạn code. Còn khi nói về semantics, bạn đang nói về việc có một cỗ máy diễn giải đoạn code đó, dù nó có được compile hay không, và cỗ máy đó làm một điều gì đó; semantics là điều cỗ máy thật sự làm. Theo Martin, rõ ràng hai thứ này rất khác nhau. Ví dụ, có những semantics mà bạn thậm chí không thể suy ra bằng cách nhìn vào syntax. Bạn không biết cỗ máy sẽ làm gì.
Jad chen vào: bạn kiểu phải test nó. Martin nói tiếp (video đăng ngày 16/10/2026): bạn phải test nó, và khi test, nó có thể đi theo đủ mọi hướng khác nhau. Một ví dụ rất kinh điển là SQL. Bạn có thể viết một câu SQL query, nhưng nó thật sự chạy ra sao, chạy mất bao lâu, phụ thuộc hoàn toàn vào, chẳng hạn, schema trông thế nào hay dữ liệu trong database trông thế nào, vân vân.
Jad đáp (video đăng ngày 16/10/2026): nhưng anh sẽ không gọi đó là semantics. Anh sẽ gọi đó là performance characteristics (đặc tính hiệu năng). Có tiếng đáp: "Oh, sure." Jad nói tiếp: theo anh, phần semantics trong đó sẽ là, tuỳ vào hình dạng của dữ liệu hay cấu hình, bạn có thể ra những semantics khác nhau, vì như Martin nói, bạn muốn null được coi là false. Và bạn sẽ không biết điều đó trừ khi bạn cũng biết cấu hình của hệ thống, vân vân.
Martin nói (video đăng ngày 16/10/2026): được rồi, cho mục đích của cuộc nói chuyện này, anh nghĩ nên nói là có đoạn code thật sự bạn viết, và có cách hệ thống hành xử; cứ gọi cái thứ hai là semantics để hai người nói chuyện được. Có tiếng hỏi: Jad muốn gọi nó là gì? Jad nói: hai người cần đi sâu vào semantics của chuyện này và làm cho chúng rõ ràng, vì có rất nhiều… Có tiếng nói: anh biết, được rồi, mình sẽ giữ ở mức tổng quan. Martin đề nghị quay lại chủ đề.
9. Stack của Jad: Windows, WSL, Claude Code và Opus 5.5
Martin kể (video đăng ngày 16/10/2026): trước khi bắt đầu podcast, hai người đã tán gẫu, và Jad nói về việc giờ có thể làm những project mất một tuần, trong khi ngày trước sẽ cần cả một team và nhiều tháng. Anh mời Jad đi qua một chút cách Jad tự mình làm project, mức tăng năng suất Jad thấy, và một chút về stack cũng như quy trình của Jad.
Jad kể (video đăng ngày 16/10/2026): anh dùng Claude Code. Rồi anh nói sắp nói một điều khá buồn cười: anh dùng Windows. Có tiếng thốt lên: "What?" Martin hỏi: cái đó là do công ty Microsoft làm ra phải không?
Jad kể tiếp (video đăng ngày 16/10/2026): và anh dùng WSL. Vậy là anh dùng Linux cho mọi thứ, như development; không có X hay UI gì cho nó cả, anh chỉ dùng command prompt. Có tiếng hỏi: "How do you use Windows?" Jad đáp: vì anh chưa bao giờ thật sự muốn học các phím tắt.
Có tiếng hỏi: "Are you a gamer?" Martin hỏi tiếp: có phải kiểu anh tab sang Counter-Strike hay gì đó không? Có tiếng nói: "Like, why else?" Martin nói thêm (video đăng ngày 16/10/2026): anh không chê Windows; anh từng dùng nó hồi những năm 90.
Jad nói (video đăng ngày 16/10/2026): thật ra lý do duy nhất là anh chưa bao giờ muốn học các phím tắt. Anh ghét chuột một nút, ghét mấy thứ một nút, ghét số phím bổ trợ (modifier) bạn phải bấm cho các phím tắt. Anh không bao giờ hiểu: tại sao, tại sao phải phí thời gian? Có tiếng đáp: "Okay." Có tiếng nói: thế là kiểu, thôi, mình sẽ cài Linux. Martin nói: dùng Windows, ừ.
Jad nói: vậy là WSL, và anh dùng Claude Code. Có tiếng hỏi: "What is WSL?" Jad giải thích (video đăng ngày 16/10/2026): đó là Windows Subsystem for Linux. Họ chạy Linux kernel bên trong Windows trong một hypervisor và cho bạn truy cập vào nó. Theo Jad, nó tuyệt, họ đã làm tốt. Martin nói: tuyệt, Windows, WSL. Jad nói: và Claude Code. Có tiếng nhắc lại: "And Claude Code."
Jad kể (video đăng ngày 16/10/2026): điều mới nhất anh làm là dùng Opus 5.5, theo anh là một model thật sự tốt, tuyệt vời, thật sự tốt. Trong hai tuần trước đó, anh đã ship những khối khổng lồ cỡ 20 PR mà anh cứ thế đổ cho team để review, và họ kiểu: ồ. Anh bảo họ: đừng lo. Có tiếng nói: "It's horrible. It's like the new reporting structure…" (kiểu cơ cấu báo cáo mới).
Martin nói (video đăng ngày 16/10/2026): người cấp dưới review PR cho CEO; có phải đó là chỗ chúng ta đang đi tới không? Jad đáp: không, ai cũng đang viết như vậy; anh review PR của người trong team, và PR cứ bay khắp nơi.
Jad kể (video đăng ngày 16/10/2026): nhưng điều đã thay đổi nhiều trong vòng review là nhóm bắt đầu tập trung nhiều hơn hẳn vào test, và làm những thứ như golden expectations, xem chúng có đang dịch chuyển theo những cách khác nhau không, vân vân.
10. Command-line sub-agent và agent tech lead reviewer
Jad kể (video đăng ngày 16/10/2026): nhưng Opus 5 (anh nói "Opus 5" ở câu này), và mẹo anh mới học được gần đây: thay vì dùng sub-agent, về cơ bản bạn bảo Claude spin up các command-line sub-agent, vì những cái đó giữ được session liên tục theo thời gian. Vậy là bạn có thể cho nó spin up các agent này riêng ra. Bạn thậm chí có thể chạy chúng từ các session khác, vân vân. Theo Jad, điều đó cho phép bạn hiệu quả hơn nhiều xét về context.
Martin hỏi Jad chạy bao nhiêu agent. Jad hỏi lại cho rõ, và câu hỏi được nhắc lại: bao nhiêu agent. Jad trả lời (video đăng ngày 16/10/2026): thường thì anh làm việc trên khoảng ba hay bốn cửa sổ session cùng lúc, vì anh thấy nhiều hơn thế thì anh bắt đầu mất context giữa các việc khác nhau, vì chúng bắt đầu xong nhanh hơn rồi ngồi chờ.
Martin hỏi (video đăng ngày 16/10/2026): chúng có tương tác với nhau qua PR không, có phải nó chạy như vậy không? Jad hỏi lại: các sub-agent ấy à, tương tác với nhau? Có tiếng đáp: "Yeah." Jad đáp: không, chúng tương tác trực tiếp qua command line. Có tiếng đáp: "Oh, wow. Okay."
Jad kể (video đăng ngày 16/10/2026): anh yêu cầu cái agent chính, cái làm phần implementation, có một tech lead reviewer. Và về cơ bản chúng hỏi nó: cái này có hợp lý không, cái này có không hợp lý không, review PR của tôi, vân vân. Vậy là chúng cùng lặp đi lặp lại trên các PR này. Rồi chúng có một PR doc mà chúng cùng làm, kèm một design doc và mọi thứ trong đó.
Theo Jad (video đăng ngày 16/10/2026), việc đầu tiên anh làm là bảo agent đó nhờ các tech lead review PR doc. Anh đi qua PRD, đi qua design doc, đảm bảo nó hợp lý, đi qua từng phần một cách chi tiết, đảm bảo mọi thuật toán đều chạy, mọi phần đều chạy, việc phân chia công việc ổn, việc phân chia giữa các PR và quan hệ giữa chúng ổn. Rồi anh bảo nó: cứ bắt đầu làm đi; tìm xem có thể song song hoá (parallelization) chỗ nào, rồi spin up các agent khác để làm những phần đó.
Jad nói (video đăng ngày 16/10/2026): nhưng rốt cuộc bạn phải gom tất cả trở lại thành một stack, và có thể đi qua từng cái một với tư cách con người, vì nếu không thì nó trở nên lộn xộn, rậm rạp, và bạn không thể thật sự xử lý nó.
11. Auto-promotion trong data lake: khoảng 10 ngày thay vì khoảng sáu tháng
Martin hỏi (video đăng ngày 16/10/2026): Jad có thể cho một hình dung về thời gian không, một project Jad làm bây giờ so với, chẳng hạn, sáu năm trước, chênh nhau bao nhiêu? Jad bắt đầu: project gần nhất anh ship là kiểu… Martin chen vào: nhân tiện, để rõ ràng, đây là production code. Jad xác nhận: đúng, đây là production code. Martin nói: vậy điều Jad sắp nói là mức tăng năng suất khi ship production.
Jad đưa ví dụ (video đăng ngày 16/10/2026): PR gần nhất anh làm, hay đúng hơn là loạt PR gần nhất, là thứ nhóm gọi là auto-promotion trong một data lake. Trong data lake, bạn lưu toàn bộ dữ liệu. Thường thì dữ liệu được lưu theo cột (column-oriented), dạng file Parquet, trong Iceberg, vân vân. Còn khi bạn lấy dữ liệu từ log, chúng là bán cấu trúc (semi-structured), với các cột tuỳ ý, vân vân.
Jad giải thích (video đăng ngày 16/10/2026): để có bố cục dữ liệu tốt nhất và để query được hiệu quả, nhanh, tình huống lý tưởng là mọi field trong log event trở thành một cột mà bạn có thể lọc độc lập với phần còn lại của các hàng. Nhóm gọi việc đó là auto-promotion hay shredding. Làm một thứ như vậy cực kỳ phức tạp: bạn phải tìm hiểu hệ thống metadata hoạt động thế nào, các commit của hệ thống metadata hoạt động thế nào, phối hợp giữa các writer khác nhau ra sao, vân vân.
Jad nói (video đăng ngày 16/10/2026): việc đó mất có lẽ khoảng 10 ngày. Ngày trước, nó sẽ mất có lẽ khoảng sáu tháng cho một người. Có tiếng thốt lên: "Wow." Martin hỏi: chỉ một mình Jad làm thôi à? Jad đáp: chỉ mình anh. Jad nói thêm: thật điên rồ.
Martin nói (video đăng ngày 16/10/2026): vậy là kiểu cải thiện gấp 10 lần, gấp 20 lần. Có tiếng đáp: "Yeah." Martin nói thêm: cho production code, cho sản phẩm mới. Có tiếng đáp: "Yes."
12. AI có đoán được hệ thống sẽ chạy ra sao không: chuyện query optimization
Martin nói (video đăng ngày 16/10/2026): một câu hỏi anh lúc nào cũng có là thế này. Anh rất hiểu rằng các model này được train trên toàn bộ code từng được viết ra, cứ tạm gọi vậy. Nên anh hiểu vì sao chúng sinh được code, tức phần syntax. Nhưng khi bạn làm infrastructure cốt lõi, giả sử bạn làm distributed algorithms, thì các tính chất, cách nó tự xử lý khi đang chạy, lại rất, rất khác. Thường thì bạn thậm chí không thể nhìn vào syntax mà biết chuyện gì sẽ xảy ra.
Martin nói tiếp (video đăng ngày 16/10/2026): giả sử bạn viết một distributed system nào đó, thì cách nó chạy, availability, thậm chí cả correctness, sẽ phụ thuộc vào workload trông thế nào: các access pattern là gì, traffic là gì. Jad hỏi: Martin đang nói về khía cạnh performance của nó, hay là… Martin nói tiếp về availability: bạn có thể phải lock mọi thứ nên nó không available trong một khoảng thời gian. Anh nói anh đang nói về correctness: có thể bạn đã quyết định dùng eventual consistency, nên nếu bạn đọc, nó sẽ không nhất quán vì không có lock. Rồi tới performance: có thể bạn cache, có thể không. Theo Martin, đó đều là các trade-off trong không gian thiết kế, và trừ khi bạn biết access pattern, bạn sẽ không biết nó chạy ra sao.
Martin nói (video đăng ngày 16/10/2026): nên anh tự nghĩ: được rồi, mình có một AI, mình hiểu được nó sẽ viết code cho một distributed data store chung chung ra sao. Nhưng anh không hiểu nó sẽ biết cách đưa ra các trade-off cần thiết thế nào, vì nó thậm chí còn không biết access pattern là gì; dữ liệu để học cách build một hệ thống hiểu được toàn bộ operations thậm chí nằm ở đâu? Ngày nay chúng ta dựa vào con người để quản lý cluster, tối ưu database, vân vân. Anh hỏi: Jad nghĩ thế nào về chuyện này; anh hiểu phần viết code, nhưng có những hệ thống vận hành sâu, Jad áp dụng AI vào bài toán đó ra sao, chúng ta đã có tiến bộ nào chưa, hay đây vẫn là một bài toán còn bỏ ngỏ?
Jad trả lời (video đăng ngày 16/10/2026): câu hỏi, theo anh, có lẽ là về độ phức tạp, và về chuyện có thể lấy những thứ thuộc về vận hành mà Martin mô tả, những thứ xảy ra trong production, rồi chuyển chúng thành thứ mà một AI có thể suy luận được, tới mức nào.
Martin nói (video đăng ngày 16/10/2026): chính xác, một AI có thể suy luận về hệ thống này thế nào. Thứ nhất, khi nó viết code, nó có thể thật sự dự đoán chuyện gì sẽ xảy ra tới mức nào, nó làm việc đó tốt cỡ nào; và thứ hai, làm sao để nó suy luận về chuyện này. Anh đề nghị hỏi câu thứ nhất trước: nếu anh dùng phương pháp của Jad, "phương pháp Jad" để viết code, và build một distributed system lớn nào đó, thì nó làm đúng về performance, về correctness thường xuyên tới đâu, và thường xuyên tới đâu thì nó hợp lý về mặt vận hành?
Martin kể (video đăng ngày 16/10/2026): nhân tiện, anh đang làm một thứ distributed liên quan tới Gaussian splat, và anh nói nó tệ hại, kinh khủng. Vì bạn có hàng triệu Gaussian splat phải page in, page out và stream. Nó phụ thuộc hoàn toàn vào hệ thống đang chạy. Và theo Martin, không model nào làm tốt việc đó.
Jad kể (video đăng ngày 16/10/2026): ở thế giới của nhóm anh, điều anh thấy là nhóm đã định nghĩa rất rõ performance benchmark trông thế nào, hệ thống nên chạy ra sao, và các ràng buộc khi build bên trong stream processor của nhóm trông thế nào để có performance đúng. Nhưng thỉnh thoảng nó sẽ làm… Project gần nhất của anh xoay quanh query optimization và query performance. Martin nói: một ví dụ kinh điển của thứ khó.
Jad kể (video đăng ngày 16/10/2026): về cơ bản nhóm đang sinh ra code tương ứng với SQL và muốn chạy nó trong một pipeline. Và anh kiểu: được rồi, mày đang sinh ra code dở tệ, sửa đi. Nó bắt đầu đi qua, và điều nó không nhận ra là ban đầu nó không hề làm tối ưu nào trên code. Nó kiểu: ồ, thế là ổn mà, trông có vấn đề gì đâu? Anh nói: này, có mấy cái conjunct ở đây; mày đang AND, và cái term này bị lặp lại, đáng lẽ phải được bỏ đi. Rồi nó kiểu: à, được rồi, để tôi tìm hiểu, vân vân.
Jad kể tiếp (video đăng ngày 16/10/2026): rồi về cơ bản nó đi theo một mạch để tìm xem, nó dựng một loạt hypothesis xoay quanh việc đâu là tất cả những thứ nó có thể đi tối ưu để làm cái này tốt hơn. Có tiếng đáp: "Yeah." Nhưng rốt cuộc, vì nó grounded được điều đó trong performance benchmark, và anh bảo nó: này, đây là một dataset gồm các query và những gì người dùng đang hỏi, vân vân, đi làm đi; thì theo Jad nó có thể làm tương đối tốt theo cách đó.
Jad nói (video đăng ngày 16/10/2026): nhưng khi tới chuyện phải nói một điều kiểu "nên cho hệ thống bao nhiêu memory?", nó không biết gì cả. Điều đó phải đến từ các experiment thật chạy trong production. Theo anh, điều các hệ thống này có vẻ đang làm tốt ở thời điểm này về mảng vận hành là nó biết rằng: này, có lẽ mình sẽ không trả lời được câu hỏi này, để mình chạy một experiment bằng cách nào đó và tìm ra thông tin đó. Nhưng tất nhiên, khi tới operations, các hệ thống production không hành xử theo cách bạn kỳ vọng. Và rốt cuộc, theo Jad, đó là lý do sự cố (incident) xảy ra.
13. Cách Grepr bắt sự cố từ sớm
Martin hỏi (video đăng ngày 16/10/2026): Jad có làm mấy thứ AI SRE không, kiểu bạn có một hệ thống đang chạy có log, bạn đưa log cho một AI và nó giúp bạn tinh chỉnh hệ thống? Có tiếng đáp: "Yes." Martin hỏi tiếp: và nó chạy tốt tới đâu? Jad vừa bắt đầu "So we're just…" thì Martin nói thêm: vì theo những gì anh nghe kể, trải nghiệm của anh với những người khác làm việc này không tốt lắm; những báo cáo anh nhận được, theo kiểu nghe kể, không tốt.
Jad trả lời (video đăng ngày 16/10/2026): có vài điều. Thứ nhất, nhóm đang làm việc đó cho cả mảng vận hành lẫn security. Nhưng cách nhóm tiếp cận không phải cách người khác đang làm từ góc nhìn AI SRE. Theo Jad, nhiều hệ thống trong số đó về cơ bản bắt đầu từ một lagging indicator (chỉ báo trễ), kiểu: metric này vừa tăng vọt, hay alert này vừa xảy ra; rồi đi ngược qua một hệ thống rất phức tạp để cố xác định vì sao điều đó xảy ra. Theo anh, đó là lý do những hệ thống đó không chạy được, vì lần ngược về một root cause thật ra rất có vấn đề.
Jad nói (video đăng ngày 16/10/2026): thay vào đó, nhóm làm theo chiều ngược lại: liệu có thể bắt đầu bằng việc tìm xem có điều gì khác biệt trong môi trường của bạn vừa thay đổi không? Liệu có thể làm clustering ở quy mô lớn, kiểu tìm một cây kim trong đống rơm ở quy mô lớn, một thứ gì đó khác đi không?
Martin hỏi lại (video đăng ngày 16/10/2026): vậy là anh đang giả định nó đã chạy ổn trước đó, giờ thì không, nên đã có chuyện gì xảy ra. Nhưng đó có thể chỉ là một thay đổi trong traffic pattern bình thường, đúng không? Jad đáp: thế cũng ổn, thế cũng ổn.
Jad giải thích (video đăng ngày 16/10/2026): điều nhóm đang nhìn vào là khi mọi thứ trục trặc, thường thì hệ thống sẽ báo cho bạn là có gì đó không ổn, bằng cách nào đó. Nếu nó chạy ổn và scale bình thường thì sẽ không có gì xảy ra; nhưng đôi khi bạn sẽ thấy một message kiểu "error, connections ran out", hay "memory exceeded", hay "resource buffers emptied", hay một dấu hiệu nào đó, một kiểu cảnh báo thật sớm rằng đã có chuyện gì xảy ra. Đó là message mà nhóm muốn bắt được, rồi đi từ đó xem đó có phải một vấn đề thật mà nhóm cần điều tra và xử lý không.
Martin hỏi: vậy nó chạy ra sao? Jad đáp (video đăng ngày 16/10/2026): cho tới giờ, nó đang chạy khá tốt. Nhóm đang chạy nó nội bộ trong các hệ thống của nhóm, và đã chạy nó trong môi trường của một vài khách hàng. Và đã có một vài trường hợp nhóm bỏ qua nó, và những trường hợp đó biến thành sự cố production. Có tiếng thốt lên: "Really? Oh, wow."
14. State space, predictive model và AI; vận hành cluster thì theo Jad là chưa
Martin nói (video đăng ngày 16/10/2026): về mặt trực giác, anh hiểu được vì sao các model này hiểu syntax, vì như anh đã nói, chúng được train trên toàn bộ code từng được viết ra, và hoá ra điều đó bao phủ rất nhiều trường hợp hữu ích. Nhưng anh thấy khó mà nghĩ ra được một giới hạn (bound) cho việc vận hành thật sự của phần mềm.
Martin nói tiếp (video đăng ngày 16/10/2026): anh cảm thấy, đây là một phát biểu nghe vô lý nhưng thật ra cũng khá đúng, mỗi lần bạn thêm một bit vào một chương trình, state space của những gì nó có thể làm khi vận hành tăng gấp đôi. Nên bạn rất nhanh đi tới chỗ có nhiều trạng thái hơn số nguyên tử trong vũ trụ. Và có thể lập luận rằng đây là lý do các cách tiếp cận dạng sản phẩm cho operations chưa bao giờ thật sự hiệu quả; mấy thứ chaos engineering chưa bao giờ thật sự hiệu quả. Thật ra, bí mật không mấy hay ho suốt một thời gian rất dài của việc vận hành một distributed cluster là chỉ có con người quản lý nó.
Martin hỏi (video đăng ngày 16/10/2026): rồi để thậm chí train được một AI làm việc đó, bạn phải có đủ dữ liệu và đủ cấu hình. Nên anh tò mò: Jad có nghĩ chúng ta đã tới lúc có thể dùng AI để vận hành một distributed cluster, hay vận hành một trong những service này chưa, hay điều đó vẫn còn đang tới?
Jad trả lời (video đăng ngày 16/10/2026): anh nghĩ đã có đủ để nó bắt đầu được vòng lặp đó. Anh đồng ý với Martin là có một không gian vô tận, có rất nhiều thứ khác nhau, nhưng rốt cuộc con người cũng vận hành dựa trên runbook. Đúng là có rất nhiều thứ xảy ra trong production mà rốt cuộc bạn cần một người đi kiểu: này, cái này quá phức tạp, có một trạng thái bị ẩn mà tôi biết, vì hôm trước tôi nói chuyện với một anh khác ở chỗ bình nước và anh ấy kể cho tôi về một thứ anh ấy vừa deploy. Có rất nhiều thứ có thể không hiện ra trong trạng thái của hệ thống.
Jad nói tiếp (video đăng ngày 16/10/2026): nhưng anh sẽ lập luận rằng mục tiêu là đi tới chỗ có đủ telemetry và đủ hiểu biết để làm cho mọi thứ thật sự nhìn thấy được: đây là hệ thống trông như thế nào, đây là cách nó đang chạy, vân vân. Rồi anh nghĩ rốt cuộc, hầu hết các vấn đề thật sự lộ ra trong operations, giả sử hệ thống trước đó đang chạy ổn, là do một kiểu thay đổi nào đó. Và nếu bạn có thể tập trung vào mục tiêu tìm ra thay đổi đó là gì, rồi đi qua…
Martin hỏi (video đăng ngày 16/10/2026): anh đoán đây là một câu hỏi ngớ ngẩn: anh chưa bao giờ nghĩ các generative model này giỏi dự đoán mọi thứ tới vậy. Còn có vẻ Jad đang nói nhiều về predictive modeling: bạn dự đoán một thay đổi, hay bạn lấy baseline rồi phát hiện một bất thường (anomaly). Anh có đang nghĩ sai không?
Jad đáp (video đăng ngày 16/10/2026): không, Martin không nghĩ sai. Vì mục tiêu không phải là để agent cố dự đoán, mà là để nó nhận được một signal rằng có gì đó đã thay đổi. Có tiếng nói: "Oh, that's something." Martin nói: "I see. I see." Có tiếng nói: "Wait, wait." Martin hỏi: vậy có một model riêng làm phần dự đoán, rồi model đó sẽ báo cho AI? Có tiếng đáp: "Yes." Có tiếng nói: "Okay." Có tiếng đáp: "Yes." Có tiếng nói: "That makes sense."
Jad giải thích (video đăng ngày 16/10/2026): điều nhóm làm là, về cơ bản, bạn đưa cho nhóm petabyte log mỗi ngày của bạn, và nhóm quét toàn bộ. Mỗi lần nhóm thấy một kiểu pattern mới xuất hiện trong log của bạn, một thứ mới nhóm chưa thấy trước đây, nhóm đẩy nó lên cho AI. Có tiếng đáp: "I see."
Martin tóm lại (video đăng ngày 16/10/2026): vậy đó là predictive model làm đúng việc mà predictive model giỏi, tức xác định những thứ nằm ngoài chuẩn (out-of-norm), vân vân. Có tiếng đáp: "Exactly." Martin nói tiếp: và nó đi tới AI, AI dùng nó để tìm ra nên làm gì.
Jad đáp: "Exactly." Jad giải thích (video đăng ngày 16/10/2026): vậy là AI có thể suy luận và đào sâu xuống. Nó có thể nói: ồ, message này, để tôi xem code và tìm xem nó đến từ đâu, hiểu đoạn code đó làm gì; để tôi xem nó đã từng xảy ra trước đây chưa. Về cơ bản nó chạy tất cả các hypothesis và heuristic đó để cố hiểu: điều này có hợp lý không, nó có ý nghĩa theo một cách nào đó không? Rồi nó có thể quyết định làm gì với nó.
Martin hỏi (video đăng ngày 16/10/2026): quay lại query optimization, không phải log hay gì kiểu đó: theo Jad, chúng ta còn cách bao xa để một AI về cơ bản làm được công việc mà trước đây một người làm, khi nói tới query optimization? Jad đáp: anh nghĩ là rất gần. Có tiếng hỏi: "Really?" Có tiếng đáp: "Yes." Có tiếng nói: "Wow." Jad nói: anh nghĩ vậy.
Martin hỏi tiếp (video đăng ngày 16/10/2026): còn vận hành một distributed cluster thì sao? Anh nghĩ: bạn có một người, PhD ở MIT (Martin nêu tên một người cụ thể), đang vận hành một distributed cluster. Nếu cluster sập, công ty không chạy được; nếu nó chạy, thì nó chạy. Anh không biết. Chúng ta đã tới lúc mà Jad sẽ nói một AI làm được việc đó chưa?
Jad đáp (video đăng ngày 16/10/2026): chưa, chưa đâu. Có tiếng nói: "Okay." Jad nói: anh nghĩ, rất đơn giản thôi, khi anh và mọi người bắt đầu dùng AI cho coding, nó là autocomplete. Có tiếng đáp: "Yeah." Và không ai thật sự biết có thể build phần mềm phức tạp bằng AI tới mức nào. Có tiếng đáp: "Yeah." Khi nhìn vào nó, mọi người kiểu: à, AI sẽ không bao giờ build được X, Y hay Z, hay gì đó. Rồi về cơ bản nó vượt qua kỳ vọng, vì mọi người đã có thể mô hình hoá ngày càng nhiều độ phức tạp trong các hệ thống.
15. Over-provision, thế giới quan sát được và các bước debug
Martin nói (video đăng ngày 16/10/2026): anh cảm thấy mình là một người suy nghĩ rất đơn giản về chuyện này. Với anh, các model này là distribution vào, distribution ra. Và hoá ra bạn thật sự có thể train trên toàn bộ code từng được tạo ra, và cái manifold đó thật ra khá dễ quản lý. Anh chỉ không biết operations có bị giới hạn theo cùng một cách như vậy không. Anh cảm thấy nó giống vũ trụ hơn: heavy-tailed, dựa trên ngoại lệ, power law, và đủ thứ khó nhằn mà các model này phải học. Nhưng anh không biết; Jad là người trong nghề, nên có thể không phải vậy, có thể chúng quản lý được.
Martin nói tiếp (video đăng ngày 16/10/2026): nhưng anh sẽ nói với Jad rằng lịch sử của các hệ thống, như Jad biết, là bạn luôn muốn build một thuật toán thông minh làm điều hiệu quả: quản lý virtual memory thông minh, congestion control thông minh, routing thông minh. Và thay vào đó chúng ta làm gì? Lần nào cũng vậy, chúng ta over-provision. Anh nói chúng ta biết là chúng ta over-provision mọi lần, đúng nghĩa đen, mọi lần.
Martin lấy ví dụ (video đăng ngày 16/10/2026): hãy nhớ swap memory, khi bạn swap xuống đĩa; nếu bạn làm vậy thì coi như xong, máy tính của bạn chết. Nên chúng ta over-provision RAM, đúng nghĩa đen. Còn routing: bạn biết có bao nhiêu thuật toán adaptive routing không? Chúng ta sẽ phản ứng theo traffic, nhưng bạn bị dao động (oscillation); kiểu: thôi kệ, over-provision; chúng ta dùng ECMP. Nên anh cảm thấy lịch sử của các hệ thống là bạn không dự đoán, bạn over-provision, vì bạn không dự đoán được.
Martin nói (video đăng ngày 16/10/2026): vậy ở phía vận hành, hoặc là chúng ta sẽ build trước các hệ thống được over-provision, để bạn không phải làm những việc vận hành phức tạp, hoặc có thể AI làm được việc đó theo cách một con người làm. Nhưng anh nghĩ nó rất khác code, vì bạn đang xử lý các ngoại lệ, không có nhiều dữ liệu, vân vân. Anh cảm thấy đây là một miền khác, nhưng anh không biết; anh là VC.
Jad nói (video đăng ngày 16/10/2026): lý do anh lạc quan hơn ở đây là anh sống trong một thế giới mà việc nhóm làm là xử lý thế giới quan sát được (observable world). Martin nói: anh định nói là Jad đúng nghĩa đen là chuyên gia về chuyện này, anh hỏi Jad những câu này thậm chí còn ngớ ngẩn. Có tiếng đáp: không hề.
Jad giải thích (video đăng ngày 16/10/2026): vì trong thế giới của anh, giả định của anh là chúng ta có toàn bộ dữ liệu: chúng ta biết chính xác khi nào một thứ mới xảy ra, khi nào một ngoại lệ xuất hiện, khi nào một workload thay đổi, hay gì đó. Trong thế giới của anh, tất cả những thứ đó đã được thu thập và stream qua rồi.
Martin nói (video đăng ngày 16/10/2026): nhưng model thì không được train trên một nguồn grounded cho những thứ đó. Jad đáp: không, không. Có tiếng nói: việc đó sẽ thật sự khó. Jad nói (video đăng ngày 16/10/2026): đúng. Nhưng câu chuyện ở đây không phải kiểu "này ông Claude, đây là một đống log, có chuyện gì đang xảy ra không?". Nó phải có khả năng chạy experiment nhiều hơn hẳn, đào sâu vào và xem đâu là những hình dạng khác nhau của các chuỗi diễn biến có thể có, những chuỗi thật sự khớp với môi trường đang tồn tại.
Martin nói (video đăng ngày 16/10/2026): anh hiểu rồi; đây là điều Jad đã nói trước đó, giờ anh hiểu ý Jad. Jad đang nói rằng vũ trụ là heavy-tailed; số những điều tồi tệ có thể xảy ra có lẽ là chuyện ngoại lệ, nhưng tập các bước dùng để debug nó thì quản lý được. Đó là thứ bạn có thể dạy cho một trong các model này. Và vì thế, nếu bạn cho nó đúng signal, nó có thể đi qua một số bước để thật sự thu hẹp bài toán này lại.
Jad đáp: "Exactly." Martin nói: "Interesting." Có tiếng nói lại: "Exactly." Martin nói tiếp (video đăng ngày 16/10/2026): vậy là nó thật sự đang đảm nhận vai trò của con người. Vì hãy nhớ cả làn sóng chaos engineering; lý do nó không đi tới đâu là bạn cố rất nhanh thu nhỏ một state space cỡ số nguyên tử trong vũ trụ và làm cho nó quản lý được, trong khi chính con người mới là người đi qua các bước để làm việc đó khi debug thật. Và đây là điều Jad đang nói AI sẽ làm.
Jad đáp (video đăng ngày 16/10/2026): đúng, đúng vậy. Mục tiêu không phải là để model chỉ nói "đây là chuyện xảy ra". Mà là: này, chạy qua workflow này để xác định chuyện gì đã xảy ra.
16. Security, Planck length và câu chuyện về MP3
Jad kể (video đăng ngày 16/10/2026): nhóm cũng đang thử cách đó ở phía security. Ví dụ, trong security, có điều gì đó khác đi trong các số liệu thống kê của bạn, một khác biệt về hành vi xét theo những entity nào đang tồn tại, cardinality của nhiều thứ khác nhau đang tồn tại. Điều đó trở thành một nhiễu động (perturbation) trong cái, gì cũng được, vũ trụ. Nhóm lấy signal đó, đưa vào một AI và nói: này AI, hãy nghĩ ra một loạt causal chain có thể có, rồi đi qua và kiểm chứng xem có cái nào khớp với pattern của dữ liệu nhóm thật sự thấy không. Theo Jad, việc đó trở thành kiểu: tìm cái lỗ vừa với cái chốt này.
Martin nói (video đăng ngày 16/10/2026): với anh, cái đó còn có vẻ khó hơn nữa. Vì với operations, lập luận là hệ thống có thể rơi vào những trạng thái hỏng rất hiếm, và có rất nhiều trạng thái hiếm như vậy. Nên đó không phải thứ bạn có thể train một model, vì có quá nhiều trạng thái hiếm và tồi tệ nó có thể rơi vào. Có thể bạn giảm được điều đó bằng cách làm theo các bước.
Martin nói tiếp (video đăng ngày 16/10/2026): còn security có vẻ khó hơn nữa, vì đây không chỉ là trật tự tự nhiên của các trạng thái hiếm; bạn thật sự có một đối thủ (adversary) đang cố tình tìm các trạng thái hiếm và cố tình tìm những thứ mà bạn không làm được. Nên có thể sẽ là code được giải quyết, còn operations thì mất lâu hơn một chút.
Jad nói (video đăng ngày 16/10/2026): nhưng hãy nghĩ thế này, anh không biết nữa, với anh cả thế giới ở một mức độ nào đó đều bị lượng tử hoá, tới Planck length; có phải các nhà vật lý nói vậy không? Có tiếng nói: anh không biết, anh không phải nhà vật lý. Martin nói: đúng nghĩa đen là anh không biết mình đang nói gì lúc này, nhưng anh thật sự nghĩ rằng không thời gian được rời rạc hoá thành Planck length.
Jad nói (video đăng ngày 16/10/2026): nhưng đúng, anh đồng ý ở một mức độ nào đó với điều Martin vừa nói. Nhưng với operations và các hệ thống nói chung, có một sự rời rạc hoá các trạng thái có thể có và các đường đi qua chúng. Jad nói: "Yeah. Right." Martin bắt đầu một câu: anh chỉ nghĩ là khi bạn xử lý… Jad nói: có thể có rất nhiều trạng thái như vậy, có thể có rất nhiều.
Martin bắt đầu kể một câu chuyện (video đăng ngày 16/10/2026). Anh hỏi Jad có nhớ một người trong nhóm cao học của hai người không, và có tiếng đáp là có. Martin kể: anh nhớ có lần người đó tới gặp anh, trông rất buồn, và nói: "Martin, tôi vừa nhận ra một điều thật buồn", nếu bạn lấy bất kỳ file MP3 nào (Martin hỏi: còn nhớ MP3 không? Có tiếng đáp: "Yes."), thì MP3 có kích thước hữu hạn, giả sử bốn phút thì cỡ bốn megabyte, và điều đó có nghĩa là có một số lượng hữu hạn bài hát trong vũ trụ, vì tất cả đều được làm từ bit, và nó là bốn megabyte, và điều đó có nghĩa là bạn có thể liệt kê ra từng cái một. Người đó rất buồn với ý niệm về sự hữu hạn của âm nhạc. Theo Martin, hai người đang đi bộ ở the Dish khi có cuộc trò chuyện này.
Martin kể tiếp (video đăng ngày 16/10/2026): và anh văng một câu tục rồi nói: ông bạn ơi, ông có biết ông đã vượt qua số nguyên tử trong vũ trụ nhanh tới mức nào không? Ông còn chưa đi tới một K. Nó kiểu hai mũ hai mũ hai mũ hai. Ông đang nói gì vậy? Vui lên đi. Hai mũ hai mũ hai, bốn megabyte. Có tiếng nói: "Four megabytes?" Martin nói: có quá nhiều state, vui lên đi, về hiệu quả thì đó là vô hạn rồi, chúng ta đang nói gì vậy.
Martin nói (video đăng ngày 16/10/2026): nên anh nghĩ ở một mức độ nào đó, chúng ta thật sự đánh giá thấp số trạng thái mà các hệ thống có thể rơi vào. Và anh sẽ nói với Jad, từ góc nhìn của một VC nhìn vào các công ty này: những công ty đang cố giải quyết operations đang chật vật. Theo Martin, việc đó có vẻ khó hơn rất, rất nhiều so với những công ty đang giải quyết phần code, vì anh nghĩ đó là một bài toán khó hơn nhiều.
17. Operations khó hơn code: manifold, simulation và AI trong nghề VC
Jad nói (video đăng ngày 16/10/2026): anh đồng ý 100%. Đó là một bài toán khó hơn nhiều. Và không chỉ vì bản thân các hệ thống, mà còn vì có những tải bên ngoài ngẫu nhiên cứ thế ập tới bạn; hoặc ai đó vừa ship một thứ mới và rollout nó lên production mà không báo ai; hoặc có một trạng thái nào đó thật sự xảy ra khi thứ này xảy ra và thứ kia xảy ra, rồi bạn rơi vào deadlock. Nó cũng vì nó dính tới con người nhiều hơn rất nhiều, không chỉ một người là người viết code. Nó còn dính tới…
Martin chen vào: ồ, đúng rồi, các nguồn kiến thức (pools of knowledge) cũng bị phân tán. Jad đáp: "Exactly." Jad nói tiếp (video đăng ngày 16/10/2026): và cả sự tương tác giữa những gì cần có để kết nối các mảnh và ghép chúng lại với nhau.
Jad nói (video đăng ngày 16/10/2026): nhưng rốt cuộc, anh nghĩ về chỗ AI đang đứng, về những tương lai có thể xảy ra, về độ sâu và khả năng nhìn về phía trước của tất cả mọi thứ. Anh nghĩ code, với anh, là một mô hình thu nhỏ (microcosm) của… có lẽ anh quá định mệnh (fatalistic), có lẽ anh quá bi quan về cách thế giới vận hành, và anh nghĩ mọi thứ đều đi theo một kiểu đường đi xác suất nào đó. Nên với anh, nếu chúng ta làm cho nó chạy được với code, chúng ta có thể tiếp tục mở rộng mức độ phức tạp đó từng chút một, thêm từng lớp, từng lớp, cho tới khi xử lý được những bài toán đó của operations.
Martin nói (video đăng ngày 16/10/2026): nhiều người sẽ nói đó không phải định mệnh, mà ngược lại, rất lạc quan; đó là điều người ta sẽ nói. Còn với anh, anh không nghĩ vũ trụ dễ dàng để lộ bí mật của nó như vậy, nhưng rồi sẽ thấy. Theo Martin, đây là câu hỏi lớn, và tính tới giờ nó vẫn chưa phải một câu hỏi đã có lời giải.
Jad đáp (video đăng ngày 16/10/2026): không, ừ, không, nhưng anh không biết; rất nhiều thứ mà với tư cách con người chúng ta nghĩ là ngẫu nhiên hay không thể giải quyết, và đó là điều chúng ta đã thấy với coding. Ban đầu người ta nghĩ thế giới khả dĩ của tất cả những thứ bạn có thể hiện thực bằng code là khá giới hạn, và bạn không thể thật sự làm cho một hệ thống hiểu được toàn bộ độ phức tạp của một bộ não con người cần có. Anh nghĩ theo thời gian, tất cả sẽ… Jad nói thấy thật buồn cười là anh đang nói điều này với Martin, trong khi Martin là VC nhìn vào tương lai mà lại kiểu: không.
Martin nói (video đăng ngày 16/10/2026): anh sẽ nói quan điểm của anh. Theo anh, khi nghiên cứu các model này: bạn train trên dữ liệu, và dữ liệu đó biểu diễn một distribution; distribution đó hữu ích hoặc không. Và khi bạn train trên ngôn ngữ, việc nó hữu ích, với anh, cho thấy con người thật đáng kinh ngạc, vì họ đã nhìn vào vũ trụ, một hệ thống có số chiều rất cao, và thu nó về một manifold thật sự hữu ích cho một model. Có tiếng đáp: "Yes."
Martin nói tiếp (video đăng ngày 16/10/2026): đúng, nhưng điều đó khác với vũ trụ. Có một phép thu gọn từ số chiều cao này; ngôn ngữ có ít chiều hơn. Và anh nghĩ code là một phép thu gọn của mọi trạng thái vận hành của một cỗ máy về những cấu trúc làm cho nó chạy. Nên với anh, vẫn còn một khoảng cách giữa các chỉ dẫn hay phần mô tả, và việc hệ thống thật sự chạy. Anh nghĩ chúng ta có thể tiến dần tới đó.
Martin nói (video đăng ngày 16/10/2026): nhưng điều anh sẽ nói là các bạn đang hội tụ về simulation: có những thứ computationally irreducible (không rút gọn được về mặt tính toán), bạn phải chạy nó mới có câu trả lời, bạn không thể dự đoán nó. Nên có lẽ chúng ta đang ở một event horizon, nơi các model sẽ giải được bất cứ thứ gì mà bạn không cần thật sự mô phỏng để có câu trả lời.
Jad hỏi lại (video đăng ngày 16/10/2026): nhưng tại sao phải nghĩ theo kiểu nó sẽ phải trả lời câu hỏi ngay bây giờ, thay vì có thể mô phỏng, xin lỗi, có thể tự lập kế hoạch thực thi của nó để thu được thông tin nó cần, để có thể… Martin đáp: ừ, có lẽ, có lẽ đó là hướng chúng ta đang đi. Jad nói: đó kiểu là điều anh đang… Có tiếng nói: "Fair enough."
Martin nói (video đăng ngày 16/10/2026): và anh nghĩ có một không gian ít chiều hơn, đó là những bước bạn sẽ làm, thứ chúng ta có thể thu gọn rất nhiều bằng AI, rồi bước nào nó không làm được thì nó có thể tạo code để làm. Jad nói tiếp (video đăng ngày 16/10/2026): hoặc nó có thể mô phỏng. Và điều Martin đang nói là: model không thể tự đi tìm ra các chiều bổ sung của thế giới mà chúng ta cần để mô hình hoá vũ trụ vào thế giới của nó. Jad nói điều đó có lẽ đúng. Nhưng liệu nó có thể mô phỏng một nhà khoa học đủ tốt để đi tới điểm đó không? Có tiếng đáp: "Maybe." Jad nói: có lẽ. Có tiếng nói: "Cool."
Jad hỏi (video đăng ngày 16/10/2026): anh hỏi Martin một câu được không: theo Martin, bao nhiêu phần công việc VC là thứ mà một AI có thể dẫn dắt?
Martin trả lời (video đăng ngày 16/10/2026): mô hình của anh về VC là nó rất dựa vào quan hệ. Anh có niềm tin rằng thị trường thật ra khá hiệu quả. Nên vấn đề không phải là tìm ra công ty mà không ai khác tìm thấy; anh nghĩ mọi người đều tìm ra đúng công ty, anh nghĩ thị trường hiệu quả. Anh cũng có mô hình về VC rằng tech là tích cực, anh khá lạc quan về mọi loại tech, và anh không lo về TAM.
Martin nói tiếp (video đăng ngày 16/10/2026): nên anh nghĩ chìa khoá là quyền tiếp cận (access): huy động vốn, quyền tiếp cận, khả năng thắng deal, và khả năng tạo thêm giá trị sau khi điều đó xảy ra. Và rất nhiều trong số đó là những thứ startup tự nhiên không làm được, như tuyển các executive lớn hay giúp việc đó. Nên theo cách anh nghĩ về venture, bạn kiểu phải là một con người mới làm được, vì đó là công việc thật sự.
Martin nói (video đăng ngày 16/10/2026): nên với phần đó, anh không nghĩ một AI… Nếu bạn cho một AI một vũ trụ mô phỏng, nơi nó có thể, gì cũng được, reward hack, kiểu xây các mối quan hệ tin cậy, thì được thôi. Nhưng anh nghĩ điều đó sẽ phải là… Dù vậy, anh sẽ nói là anh đã thấy những phân tích do AI làm ngang bằng hoặc tốt hơn bất kỳ thiên tài nào anh từng làm việc cùng. Nên với phần phân tích, chúng tuyệt.
Martin nói (video đăng ngày 16/10/2026): nhưng anh nghĩ điều này là một lời chỉ trích khả năng phân tích của giới VC nhiều hơn là nói lên các model mạnh tới đâu. Anh nghĩ tất cả chỉ là một màn kịch kabuki và nhảm nhí. Anh nghĩ những VC đúng đắn là những người kiểu: tech về tổng thể là tích cực, các làn sóng tech lúc nào cũng tạo thêm giá trị, hãy tìm công ty tốt nhất và đầu tư vào nó. Thị trường rất, rất hiệu quả. Nên anh cảm thấy câu trả lời cho câu hỏi này gần như là một chuyện kỹ thuật; câu trả lời của anh gần như là một chuyện kỹ thuật (a technicality).
18. Sau code là gì, đổi thế giới cho vừa với AI, và câu chuyện hoá đơn Datadog
Jad nói (video đăng ngày 16/10/2026): một trong những điều anh tới đây muốn hỏi Martin là: hai người bắt đầu bằng việc nói cụ thể về ops, nhưng với anh, có thế giới của AI viết code, kiểu như một thế giới mô phỏng trừu tượng mà nó sống trong đó, và rồi có phần còn lại của thế giới.
Có tiếng đáp: "Yeah, exactly." Martin nói (video đăng ngày 16/10/2026): toàn bộ cuộc thảo luận là thế này: có AI, thế giới mà AI sống trong đó, hoàn toàn là digital, gì cũng được, là training data, là thế giới của distribution; và có thế giới thật. Và hai thứ đó không nhất thiết giống nhau. Có tiếng đáp: "Right." Có tiếng nói thêm: "They're quite often not."
Jad nói (video đăng ngày 16/10/2026): vậy câu hỏi là cần train một AI tới mức nào để nó sống sót được trong một thế giới, và những thứ nó thật sự… anh không muốn trả lời câu hỏi đó, cần train cái gì. Nhưng anh tò mò về những khoảng trống còn mở. Hai người đã nói một chút về operations; Martin nói: ồ, anh không biết nó sẽ được giải quyết hay không. Còn Jad kiểu: có chứ, Martin, nó sẽ được giải quyết.
Jad nói tiếp (video đăng ngày 16/10/2026): trong đầu anh có rất nhiều thứ khác, ví dụ xe tự lái. Suốt một thời gian dài, chúng ta nghĩ điều đó sẽ không xảy ra. Nhưng theo Jad, rõ ràng là nó thật sự sẽ được làm xong và sẽ xảy ra; nó chỉ đang mất thời gian vì nhiều lý do khác nhau. Anh hỏi: vậy theo Martin, những giai đoạn tiếp theo, những lĩnh vực tiếp theo đang xếp hàng ngay sau code là gì?
Martin trả lời (video đăng ngày 16/10/2026): cảm nhận của anh là AI sẽ tiếp tục bùng lên như cháy rừng ở một miền bị ràng buộc, nơi không gian lời giải nằm trong một miền bị ràng buộc, nơi distribution của không gian lời giải giống distribution của training set. Distribution của syntax cho code giống distribution của training set. Distribution của ảnh được sinh ra giống distribution của training set. Ở những lĩnh vực đó, anh nghĩ nó sẽ tiếp tục bùng lên như cháy rừng.
Martin nói tiếp (video đăng ngày 16/10/2026): còn những miền mà distribution của lời giải là thế giới tự nhiên, anh nghĩ sẽ khó hơn nhiều và mất lâu hơn. Và anh nghĩ chuyện tương đương về kinh tế (economic equivalency) sẽ khó hơn nhiều. Theo Martin, xe tự lái là một ví dụ tuyệt vời. Anh nhớ lúc Sebastian Thrun thắng DARPA Grand Challenge khi anh đang ở Stanford, và mọi người kiểu: hoan hô, xe tự lái đã ở ngay góc phố. Anh nói nghiêm túc đấy. Và theo Martin, phải mất 20 năm và 170 tỷ đô đầu tư mới đi tới unit economics tệ hơn Uber.
Martin nói (video đăng ngày 16/10/2026): nên anh nghĩ giải các bài toán thật, nơi bạn phải xử lý distribution của vũ trụ thật, khó hơn rất, rất nhiều. Và anh xem AI là một công cụ tổng quát, một công cụ rất hiệu quả, một công cụ mà bạn có một distribution dữ liệu rồi hy vọng áp dụng nó vào một số bài toán. Chúng ta sẽ áp dụng nó vào rất nhiều thứ, và anh nghĩ cân bằng kinh tế (economic equilibrium) sẽ quyết định cái gì chạy được và cái gì không, vì anh nghĩ nó là một công cụ rất, rất tổng quát, như một universal function approximator. Và nó cân bằng ở đâu thì…
Jad nói (video đăng ngày 16/10/2026): một trong những điều anh đã nói lúc trước là AI đang huấn luyện con người dùng nó ra sao. Và anh rất hay nghĩ rằng một số bài toán có vẻ không giải được là vì thế giới vốn như vậy, và chúng ta đang cố làm cho AI hay các công cụ chúng ta build vừa với việc quản lý thế giới như nó vốn là. Nhưng trong một số tình huống, chúng ta lại có xu hướng thay đổi thế giới cho vừa với những gì chúng ta thật sự làm được.
Martin nói: ồ, 100%, tất nhiên; anh nghĩ đây là câu chuyện của robotics. Jad đáp (video đăng ngày 16/10/2026): đúng, chính xác, automated data warehouse. Câu hỏi luôn hiện ra trong đầu anh là: khi nhìn vào những data warehouse này, cái duy nhất chạy được là cái mà người ta kiểu: thôi, cứ tự động hoá toàn bộ đi. Có tiếng đáp: "Yeah, yeah, yeah." Jad nói: và anh tự hỏi tới mức nào, khi chúng ta mở rộng miền những thứ muốn giải bằng công cụ AI, chúng ta sẽ thật sự bắt đầu mô hình hoá thế giới, hay thay đổi thế giới và những thứ có thể thật sự xảy ra, cho vừa với hình dạng mà AI cần.
Martin nói (video đăng ngày 16/10/2026): anh nghĩ ở thời điểm này rất nhiều AI chỉ vận hành trong thế giới digital. Ở đó, đúng nghĩa đen, tập lời giải có cùng distribution với training set, theo một nghĩa nào đó, nên điều đó ổn. Và anh nghĩ, lại nói về cân bằng, khi bạn xử lý thế giới thật, bạn có thể giải bất kỳ bài toán nào bạn muốn; vấn đề chỉ là compute và tiền, và điểm cân bằng sẽ là một điểm kinh tế.
Martin nói tiếp (video đăng ngày 16/10/2026): một cách bạn có thể tác động lên cái hàm mà bạn đang tìm cân bằng là ràng buộc hệ thống, ràng buộc môi trường. Nên anh nghĩ giờ chúng ta đang ở trong một flywheel cân bằng kinh tế ở tầng meta, nơi chúng ta đang tối ưu một quá trình siêu tổng quát nhưng rất kém hiệu quả, với một tập lời giải mà người ta coi trọng. Và Martin nghĩ chúng ta còn 30 năm như thế này, và rất nhiều giá trị sẽ được tạo ra.
Jad hỏi Martin có muốn nghe một câu chuyện buồn cười không. Có tiếng đáp: "Yeah." Jad kể (video đăng ngày 16/10/2026): nhóm build cái thứ AI này và đi nói chuyện với mọi người, liên hệ với khách hàng: này, nhóm build cái thứ AI này, nhóm đang giúp khách hàng trở nên reliable hơn, đây là những gì nhóm đang làm. Họ kiểu: tuyệt, chúng tôi muốn nói chuyện với các anh.
Jad kể tiếp (video đăng ngày 16/10/2026): nhóm lên cuộc gọi và nói: đây là việc nhóm làm; nhóm build hệ thống này, giúp bạn tối ưu dữ liệu, giúp bạn giảm chi phí, rồi giúp bạn reliable hơn, vì giờ nhóm có thể tìm ra các vấn đề và giải quyết chúng trước khi chúng thành sự cố. Họ kiểu: khoan, khoan, khoan, quay lại. Anh vừa nói là anh có thể tiết kiệm 90% hoá đơn Datadog? Đó là thứ tôi muốn mua. Được rồi, nhưng còn cái thứ AI kia? Họ kiểu: không, không, cái kia mới là thứ chúng tôi muốn mua ngay bây giờ.
Jad nói (video đăng ngày 16/10/2026): và điều đó thú vị. Với code, anh lúc nào cũng nghĩ là người ta hiểu ngay, kiểu: trời, nó cứ thế chạy được. Có tiếng đáp: "Yeah, yeah, yeah." Jad nói tiếp: còn ở phía ops, hay bất cứ thứ gì nằm ngoài chuyện đó…
Martin nói tiếp (video đăng ngày 16/10/2026): rất khó để hiểu được giá trị thật sự, gắn một con số đô la cho nó và chịu chi tiền ra. 100%. Và anh cũng nghĩ, từ góc độ coding, nó đúng nghĩa đen là năng suất engineering, một trong những khoản mục lớn nhất trong mấy thứ này. Nên nó rất dễ hiểu.
Jad đáp (video đăng ngày 16/10/2026): chính xác. Nhưng bạn cũng có thể nghĩ về nó như năng suất của SRE, hoặc như việc doanh nghiệp của bạn bị sập: có thể bạn cứu được một sự cố, và cái giá của nó là bao nhiêu. Anh không biết, thật lạ là người ta nghĩ về nó thế nào khi ra ngoài mảng coding.
Martin nói (video đăng ngày 16/10/2026): anh cũng nghĩ là code thật kỳ diệu vì nó quá tốt, và không ai nghĩ điều đó có thể xảy ra. Còn mảng operations, theo anh, ở thời điểm này vẫn còn khá sớm, vẫn còn khá sớm. Martin cảm ơn Jad đã tới, nói đây là một cuộc trò chuyện tuyệt, và Jad đáp lời cảm ơn.
Nguồn và liên kết 6 nguồn
- Tên gốc: Why AI Can Write Code But Can’t Keep It Running (Yet)
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=blkIGLlZePg youtube.com
- Kênh YouTube a16z (Martin Casado cùng Jad Naous): youtube.com/channel/UC9cn0TuPq4dnbTY-CBsm8XA youtube.com
- Trang giới thiệu của Grepr, ghi Jad Naous là "Founder & CEO" và nói công ty được thành lập bởi những người từng làm ở AppDynamics, Imply và New Relic (đọc ngày 21/11/2026): grepr.ai/about-us grepr.ai
- Trang của Martin Casado trên a16z, ghi anh là general partner dẫn dắt mảng infrastructure của quỹ, từng là cofounder và CTO của Nicira (đọc ngày 21/11/2026): a16z.com/author/martin-casado a16z.com
Related talks
Robot-use agents: vì sao model đa dụng có thể thắng trong robotics
Ankit Gupta, Hanming Ye, Jay Chooi, Francois Chaubard & Vincent Song · Y Combinator · 30 min
Hai host YC cùng founder Waddle Labs và RoboCurve bàn về robot-use agents: từ RT-2, code as policies, in-context learning tới harness và demo điều khiển robot.
AI và game: từ Halo chạy trên web tới game không bao giờ kết thúc
Anish Acharya & Jonathan Lai · a16z · 46 min
Anish Acharya và Jonathan Lai bàn AI trong làm game: model tự dùng Blender, mod và decompile game cũ, thể loại ngách, game không bao giờ kết thúc (video 12/11/2026).
Eric Glyman: từ Paribus tới Ramp, agent biết hành động và AI bên trong công ty
Garry Tan & Eric Glyman · Y Combinator · 54 min
Eric Glyman kể với Garry Tan về Paribus, ý tưởng Ramp, agent cần khả năng hành động, Inspect, Glass và cách AI đổi việc bên trong Ramp (video 18/11/2026).