Topics / Evals
Evals
97 talks
Skill-creator mới: test, đo và tối ưu Claude skill
Ray Amjad · Ray Amjad · 13 min
Skill-creator mới của Anthropic: hai loại skill, chạy evals và A/B test mù có/không skill, benchmark, tối ưu description để skill trigger ổn định.
Tạo skill đầu tiên trong Claude
Tom Nassr · Tom Nassr | XRAY · 9 min
Tạo skill YouTube chapters bằng skill-creator trên claude.ai, dùng nó trong chat mới, rồi để Cowork chạy test và benchmark để tinh chỉnh skill.
Nhân viên Anthropic thật sự dùng Claude skills thế nào
Austin Marchese · Austin Marchese · 16 min
Năm bài học từ playbook nội bộ của Anthropic: bốn skill type, scripts và templates, verifier, gotchas và cách viết description để skill tự trigger.
Matt Wolfe thử GPT-6 Astra: benchmark, Megabonk, Blender và Unreal Engine
Matt Wolfe · Matt Wolfe · 20 min
Matt Wolfe xem benchmark của GPT-6 Astra, tự thử Busey Bench, Megabonk, một world simulator và computer use trong Blender, Unreal Engine (video 03/09/2026).
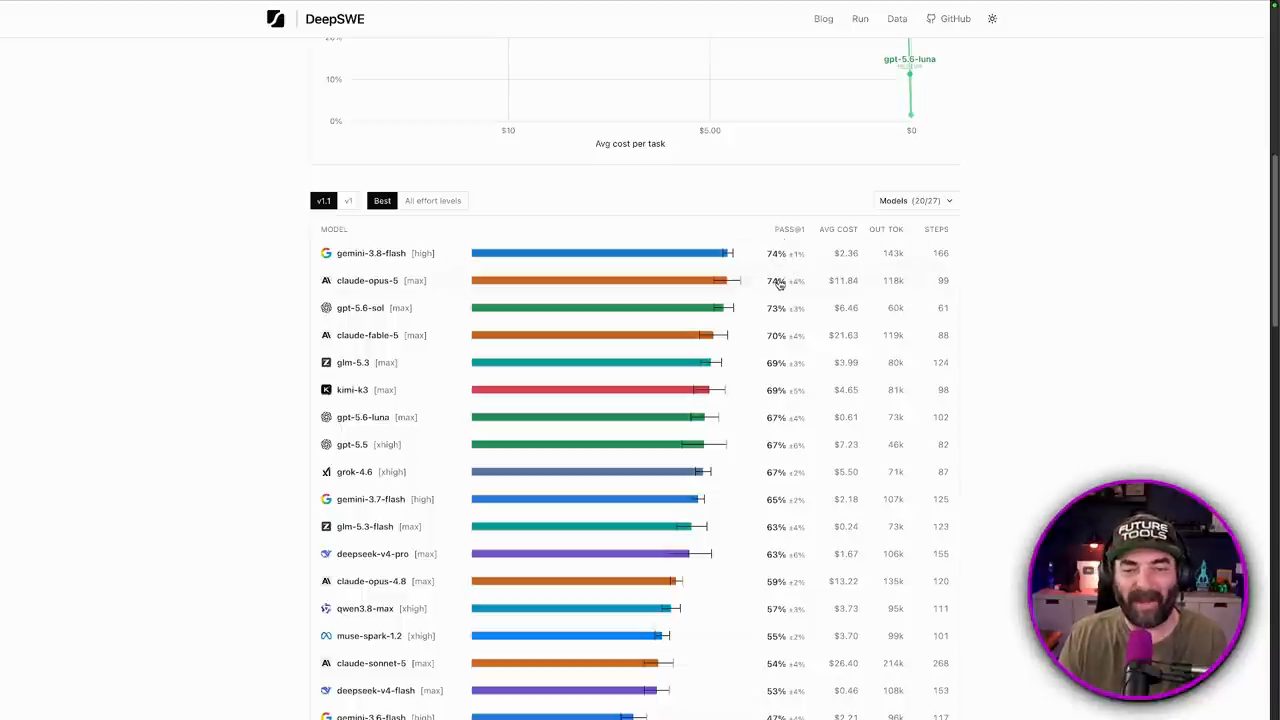
Vì sao ít ai nói về model này của Google?
Matt Wolfe · Matt Wolfe · 26 min
Matt Wolfe so Fable 5.1 với Gemini 3.8 Flash qua benchmark, chi phí mỗi task và test riêng, rồi nói về Astra và recurrent depth (video 03/09/2026).
GPT-6 Astra: benchmark ấn tượng và nỗi lo monitorability ở OpenAI
AI Explained · AI Explained · 29 min
Phân tích GPT-6 Astra (9/2026): benchmark khó, ARC-AGI-3, FrontierMath, trading, và system card về chain of thought khó giám sát, sandbagging.
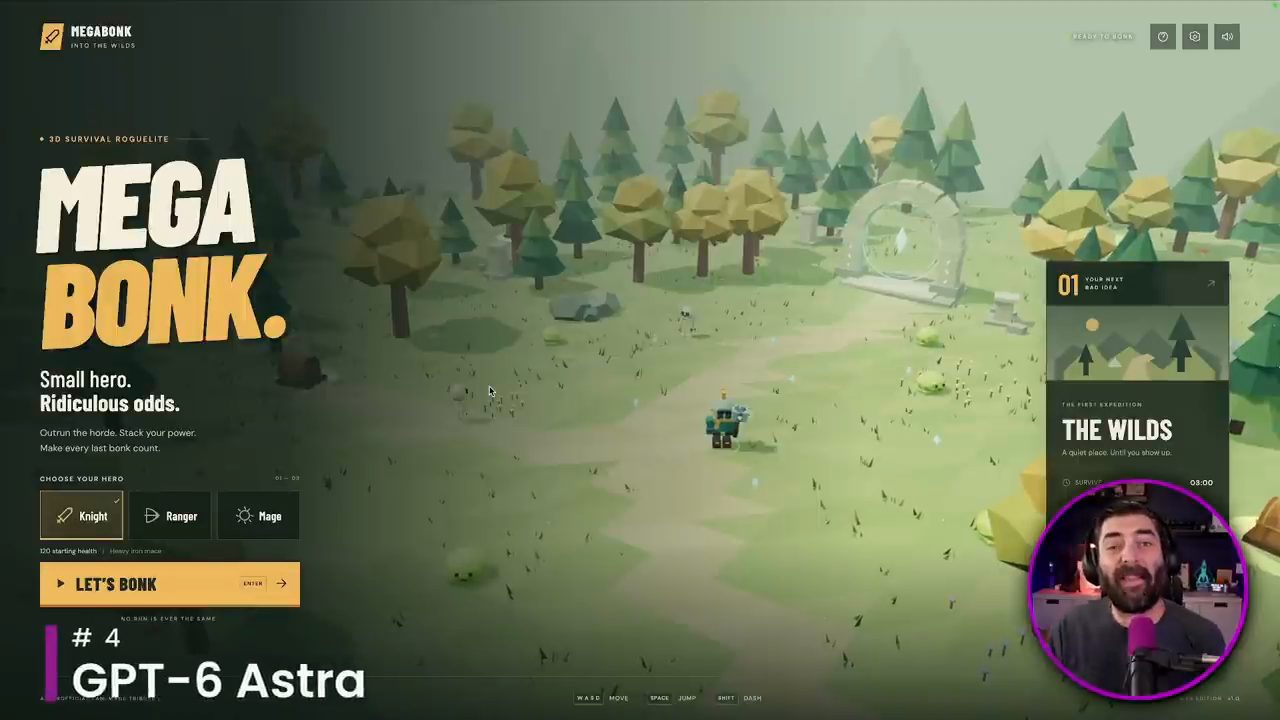
Tin AI tuần: Fable 5.1, Gemini 3.8 Flash, Muse Spark 1.3 và GPT-6 Astra
Matt Wolfe · Matt Wolfe · 31 min
Matt Wolfe điểm bốn model mới Fable 5.1, Gemini 3.8 Flash, Muse Spark 1.3, GPT-6 Astra qua benchmark và game Megabonk, rồi Atlas, Solaris và các tin nhanh.
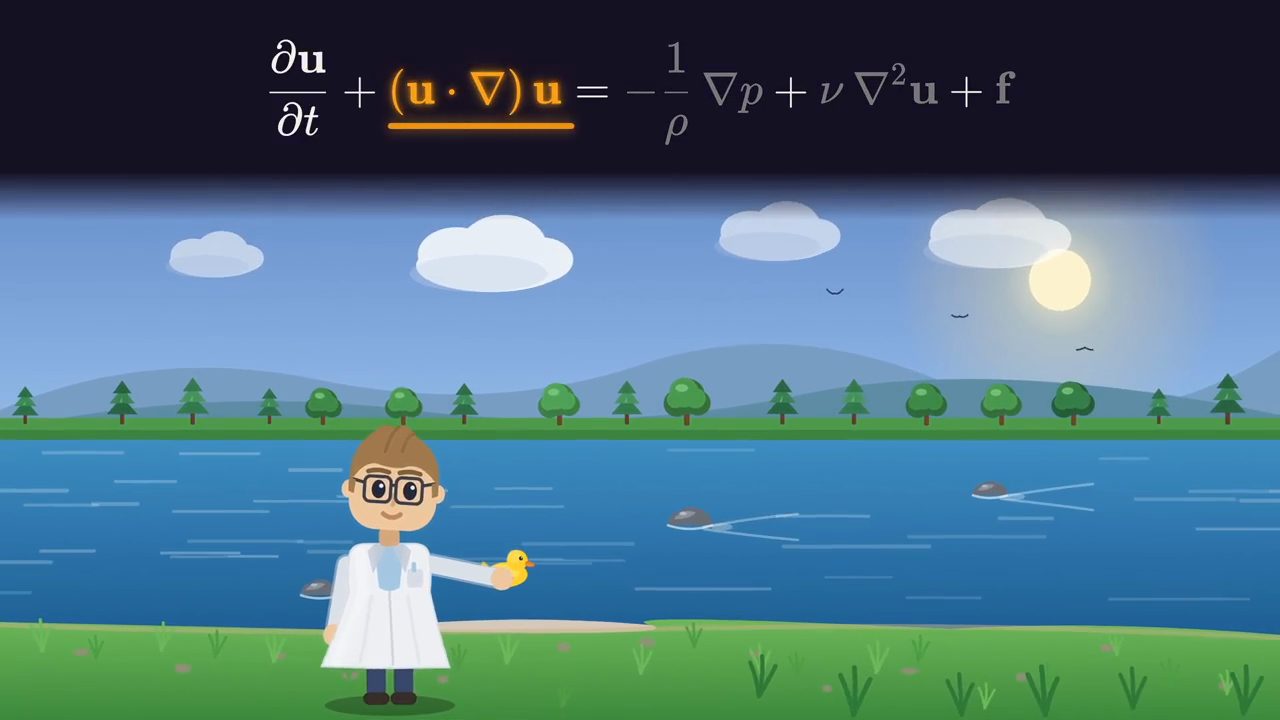
Navier-Stokes và lời giải "rất có thể" từ OpenAI
Károly Zsolnai-Fehér · Two Minute Papers · 9 min
Károly Zsolnai-Fehér giải thích phương trình Navier-Stokes, lời giải OpenAI công bố, tranh cãi quanh nó và vì sao AI giỏi toán (video đăng ngày 10/09/2026).
Tin AI tuần: giới AI đang thật sự lo sợ
Matt Wolfe · Matt Wolfe · 36 min
Bản tin AI của Matt Wolfe ngày 11/09/2026: ChatGPT Images 2.5, agent Muse của Meta, DeepSeek V4.1 Flash, các cảnh báo về rủi ro AI và sự kiện Apple.
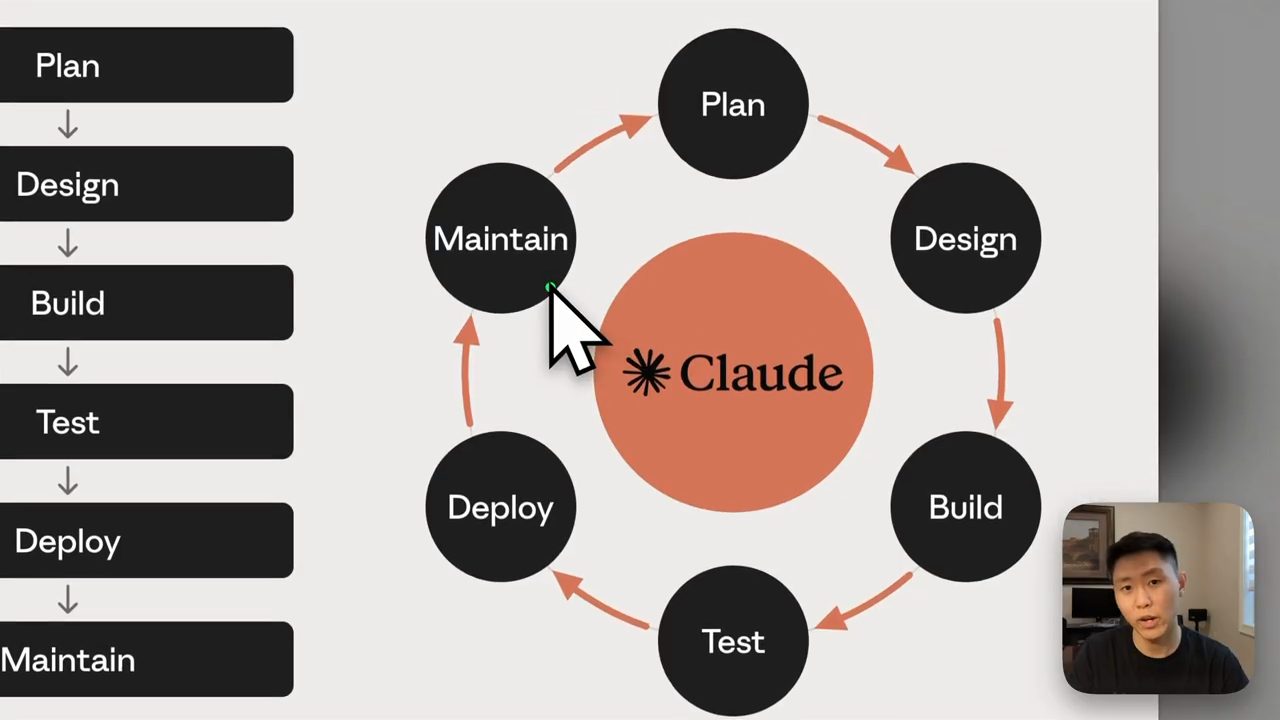
Playbook AI-native SDLC của Anthropic với Claude Code
Eric Tech · Eric Tech · 21 min
Đi qua playbook AI-native SDLC của Anthropic: intent.md, spec.md, plan.md, TDD và feedback loop, eval trong CI, review PR, hook, deploy và metrics.
Theo dùng Opus 5.5 một ngày: rẻ hơn, viết dễ đọc, vẫn có tật
Theo Browne · Theo - t3․gg · 40 min
Theo dùng Opus 5.5 trọn một ngày: giá và benchmark, token efficiency, vì sao tránh mức max, quota thực tế, front-end, demo 3D và tật sợ hết context.
Cho Opus 5.5 build cùng một app ở mọi mức effort
Nate Herk · Nate Herk | AI Automation · 27 min
Cùng một prompt dựng hội nghị 3D, chạy Opus 5.5 ở sáu mức effort rồi so chất lượng, thời gian, chi phí API, token và số check (video 24/09/2026).
Ming-Yu Liu của NVIDIA: world model, Cosmos 3 và vì sao robot gấp đồ trước khi bác trứng
Nate B Jones & Ming-Yu Liu · AI News & Strategy Daily | Nate B Jones · 46 min
Ming-Yu Liu (NVIDIA) giải thích world model, kiến trúc Cosmos 3, policy model, harness cho robot và vì sao việc kiểm chứng được quyết định robot làm gì trước.
15 bài học sau hơn 1.000 giờ dùng Claude Code
Nick Saraev · Nick Saraev · 26 min
Mười lăm mẹo dùng Claude Code của Nick Saraev: eval, tự kiểm tra, quản lý context window, MCP sang skill, task song song, handoff note, /btw, fan out và CLAUDE.md.
Opus 5.5, Fable 5.1 và GPT-6 Astra build cùng ba app
Pat Simmons · Pat Simmons · 36 min
Pat Simmons cho Opus 5.5, Fable 5.1 và GPT-6 Astra cùng làm tranh Moby Dick bằng code, launch film và game skate Blender, so chất lượng, thời gian và chi phí.
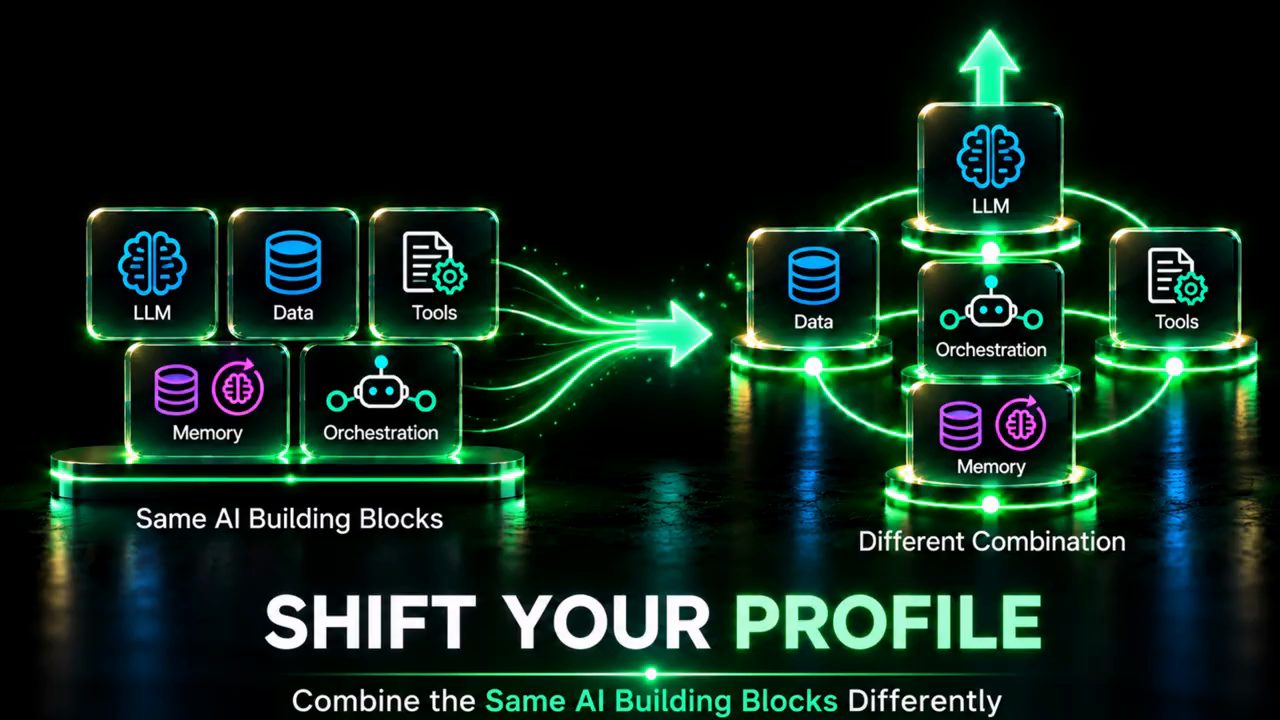
Năm project AI agent để build năm 2026: kiến trúc đầy đủ và cách trở nên dễ được tuyển
Maryam Miradi · Dr. Maryam Miradi · 28 min
Kiến trúc năm project multi-agent: cảnh báo thảm hoạ, phát hiện bệnh từ ảnh mắt, graph cho đường bộ, legal agent với ADK và MCP, agent tự cải thiện.
Bonsai 2: Qwen 27B nén còn 6 GB có làm được việc agent?
Muhammad Farooq · Prompt Engineering · 14 min
Bonsai 2 nén Qwen3.8-27B bằng ternary quantization còn khoảng 6 GB: hoà ở task ngắn nhưng không build xong app agentic nào, và cách đọc trace để thấy vì sao.
Hướng dẫn đầy đủ về Warp Factories
Benjamin Holmes · Warp · 19 min
Đi hết Warp Factories: dựng factory, agent và automation as code, chạy từ Slack, rồi đo cost per PR, scoring, self-improvement và benchmark.
Sonnet 5.5 qua benchmark và ba bản build mù: có cần Opus nữa không
Pat Simmons · Pat Simmons · 46 min
Pat Simmons so Sonnet 5.5 với Opus 5.5, Fable 5.1, GPT-6 Astra và Sonnet 5 qua benchmark và ba bản build mù, kèm token, chi phí và thời gian.
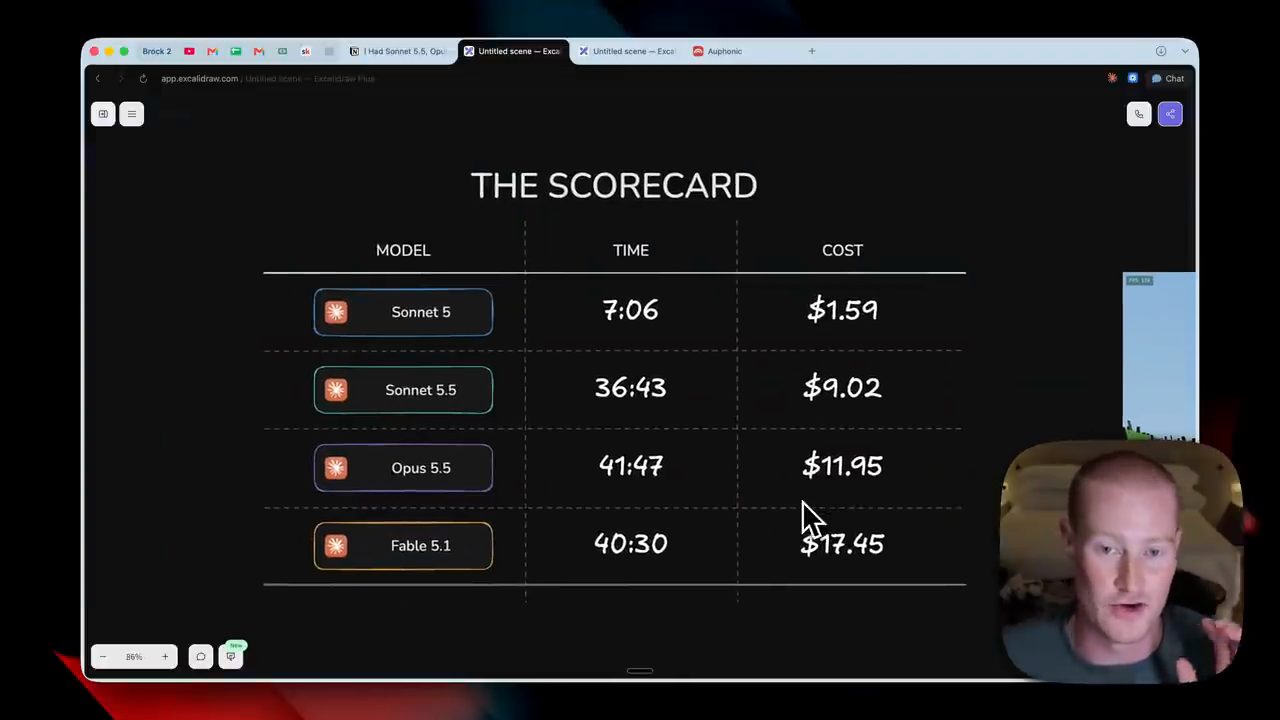
Bốn model Claude cùng làm một game 3D: thời gian và chi phí
Brock Mesarich · Brock Mesarich | AI for Non Techies · 9 min
Sonnet 5, Sonnet 5.5, Opus 5.5 và Fable 5.1 cùng làm một game 3D từ một prompt: so chất lượng, thời gian và chi phí từng model.
Bản cáo bạch IPO của Anthropic, Sonnet 5.5 và việc OpenAI giữ lại GPT-6.1 Astra
Wes Roth · Wes Roth · 15 min
Wes Roth đọc tin bản cáo bạch IPO của Anthropic (lỗ ròng 42 tỷ đô, 34 tỷ là kế toán), Sonnet 5.5 và việc OpenAI giữ lại GPT-6.1 Astra vì an toàn.
Vì sao coding agent cứ làm codebase tệ dần
Dexter Horthy & Patrick Akil · Beyond Coding · 45 min
Dex Horthy (HumanLayer) bàn về SlopCodeBench, token maxing, dark factory, nhắm nhanh hơn 2-4 lần thay vì 100 lần, và workflow research-design-plan của anh.
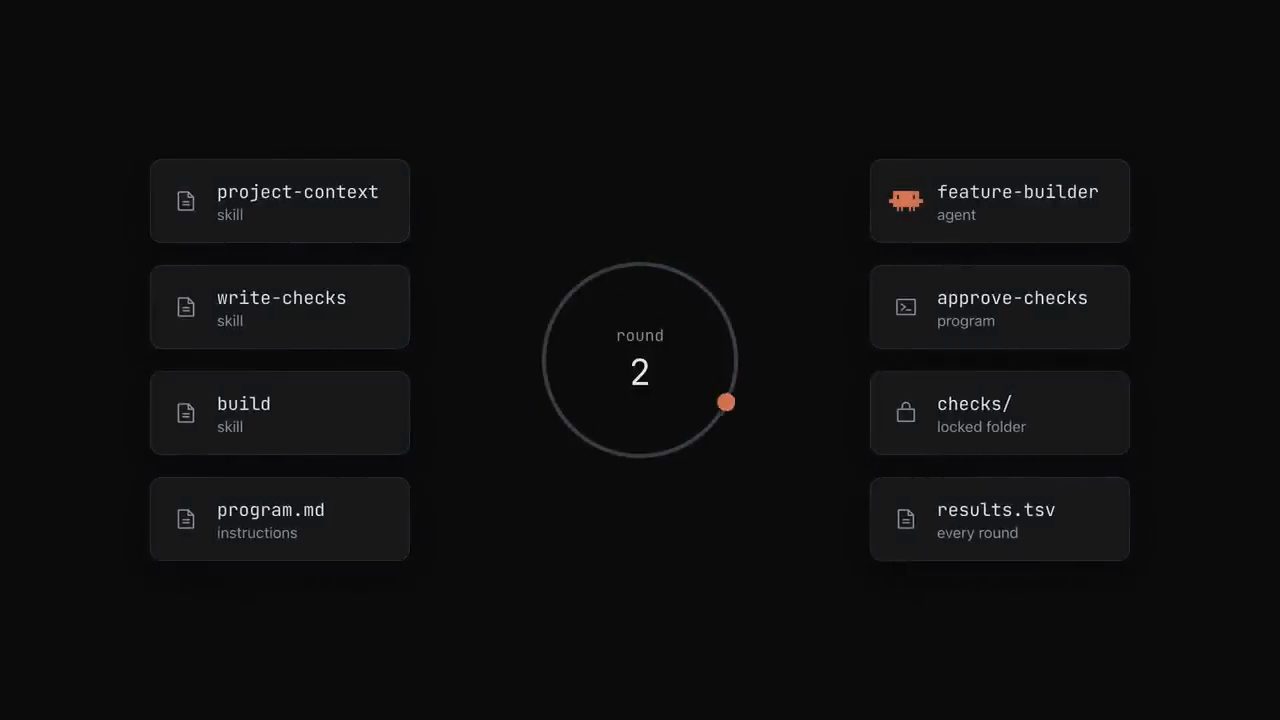
Karpathy Loop trong Claude Code và auto loop tự cải thiện
AI LABS · AI LABS · 13 min
Dựng Karpathy Loop trong Claude Code bằng skill, checks bị khoá và feature builder agent, rồi thêm auto loop viết lại program.md để sửa thói quen.
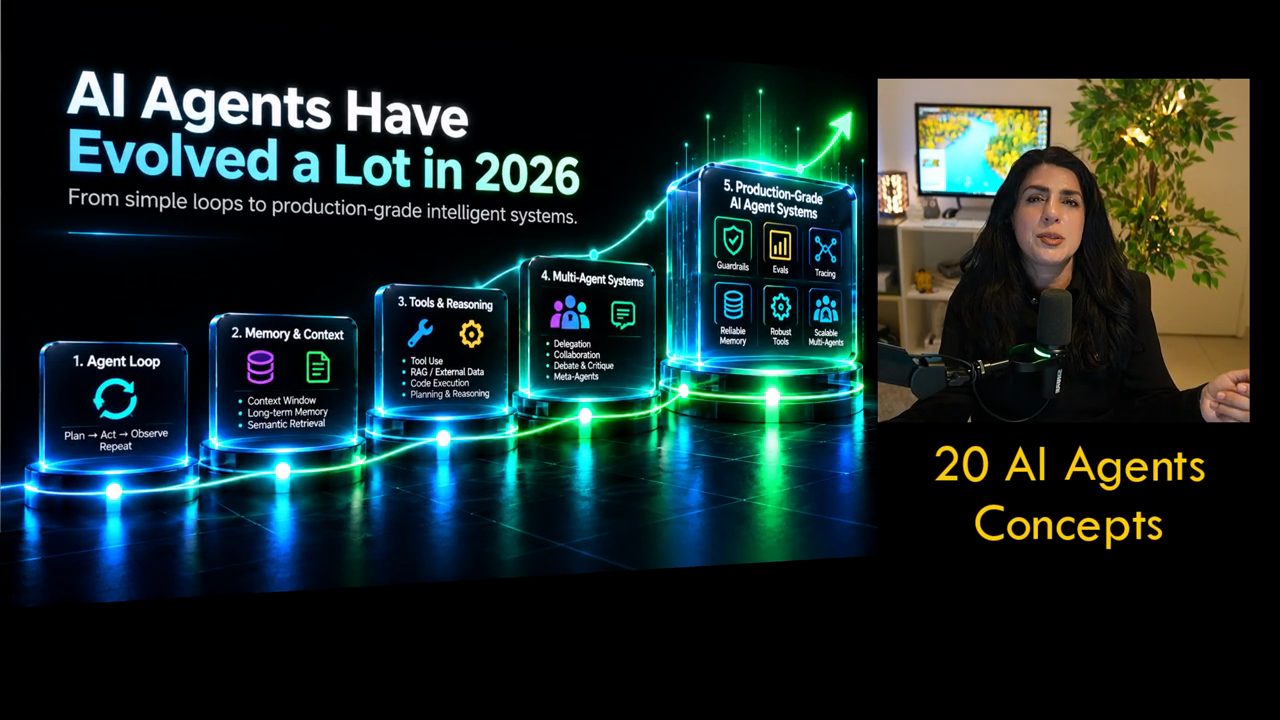
20 khái niệm nền tảng để build AI agent production, kèm code
Maryam Miradi · Dr. Maryam Miradi · 26 min
20 khái niệm AI agent qua năm layer: agent loop, planning, memory, sandbox, tool retrieval, multi-agent, guardrails, eval, prompt injection, tracing, mỗi cái kèm code.
Every Agent: một AI coworker trong Slack, xây trên Claude Managed Agents
Katelyn Lesse, Dan Shipper & Willie Williams · Claude · 34 min
Dan Shipper và Willie Williams kể Every xây Every Agent trên Claude Managed Agents: skill từ taste, đo model theo việc thật, isolation và danh tính agent.
Tự fine-tune embedding model không khó như bạn nghĩ
Muhammad Farooq · Prompt Engineering · 13 min
Fine-tune EmbeddingGemma 2 bằng LoRA và Unsloth trên dữ liệu riêng: cặp câu hỏi và đoạn văn, in-batch negatives, chia test theo nguồn, đo cái giá.
Sáu project AI sát thực tế nên có trên resume AI engineer
Aishwarya Naresh Reganti · Aish Reganti · 21 min
Sáu project AI engineer theo độ khó tăng dần, từ document pipeline, enterprise search, voice, model tự host tới agent, mỗi project có dataset, eval và cách kể.
AI có rẻ đi không? Theo đo lại chi phí theo mức trí tuệ
Theo Browne · Theo - t3․gg · 18 min
Theo giải thích vì sao hoá đơn AI tăng dù AI đã rẻ đi: giá token, token cho mỗi việc, giá theo mức trí tuệ, và nghịch lý Jevons.
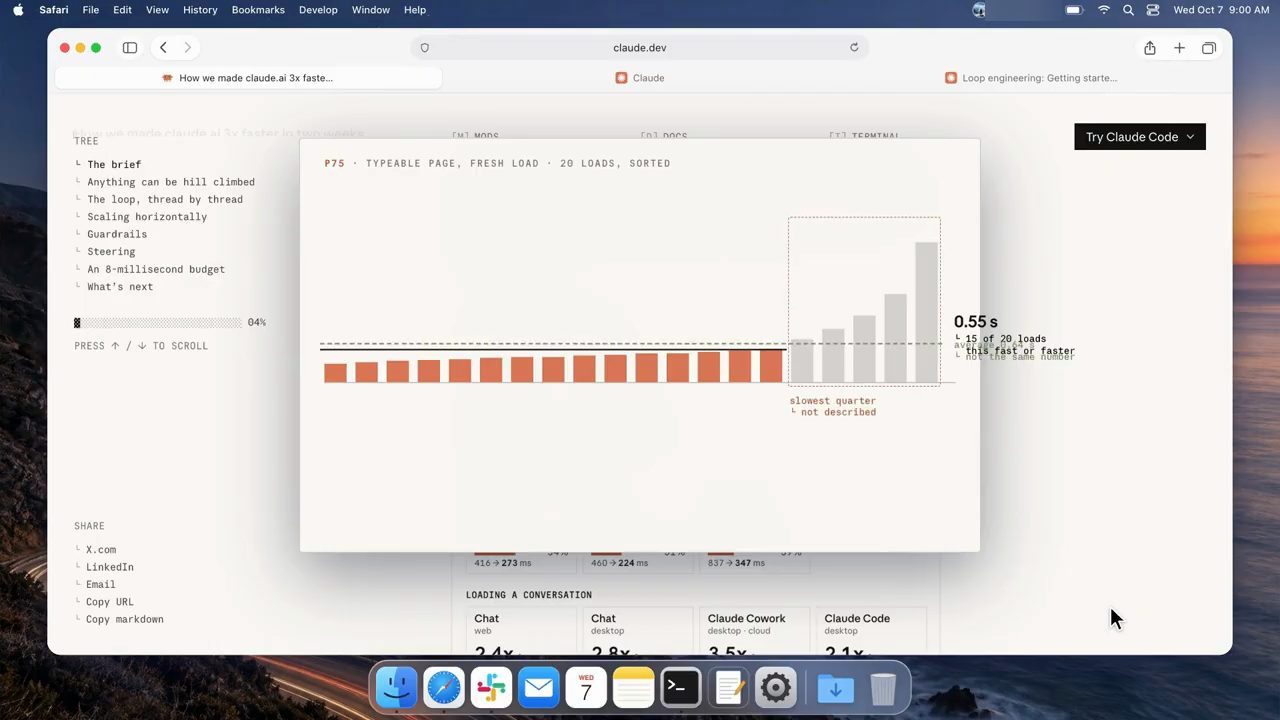
Vòng lặp Anthropic dùng để làm claude.ai nhanh gấp ba
AICodeKing · AICodeKing · 11 min
Vòng lặp Anthropic kể đã làm claude.ai nhanh hơn khoảng 3 lần trong hai tuần: instruction count, CI ratchet, field data, người duyệt mọi thay đổi.
Hai nhà sáng lập MakerMaker và Martin Casado bàn về RSI thật sự, tử số và mẫu số
Dhaval Adjodah, Owen He & Martin Casado · a16z · 32 min
Martin Casado cùng hai nhà sáng lập MakerMaker bàn RSI thật sự khác gì dùng AI làm AI, closed loop, takeoff, và cách đo tiến bộ theo cả hiệu năng lẫn chi phí.
Meta bắt kịp Anthropic: Theo dùng thử Muse Wonder Full
Theo Browne · Theo - t3․gg · 38 min
Theo thử Muse Wonder và Wonder Full của Meta: điểm yếu 3D và UI, orchestration, review code, bench tự làm, token efficiency so với Opus và GPT.
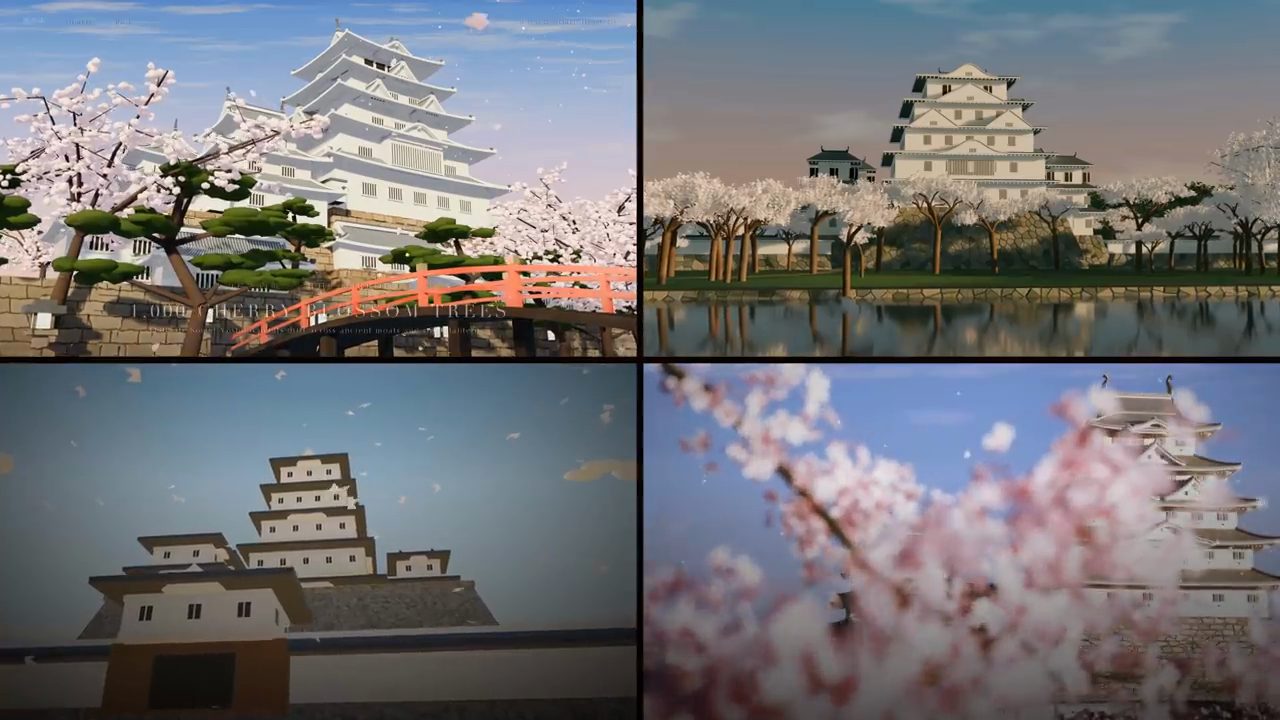
So Gemini 4, Opus 5.5, GPT-6 Astra và Muse Wonder qua 5 use case
Peter Yang · Peter Yang · 19 min
Peter Yang cho bốn frontier model làm 3D model, game, phim ngắn, website và bài viết, rồi chấm model nào thắng ở từng việc (video 13/10/2026).
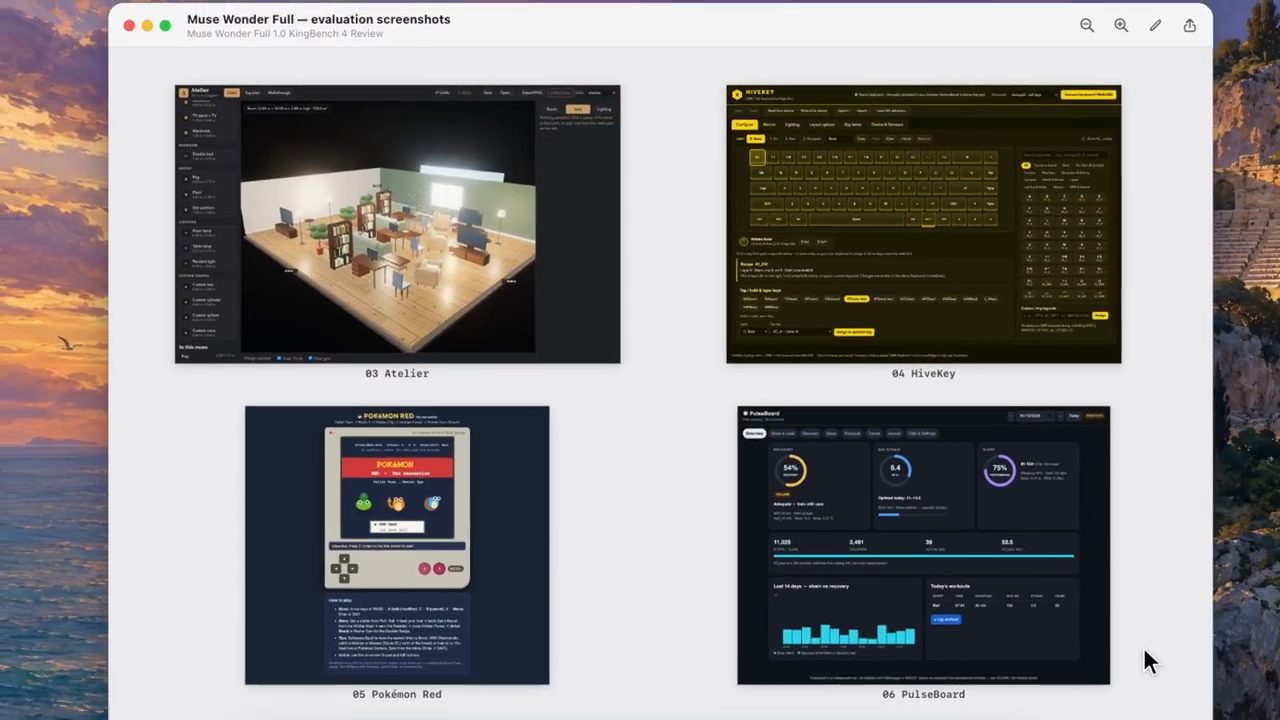
Muse Wonder Full qua sáu project KingBench 4: kiểm từng app, điểm, token và chi phí
AICodeKing · AICodeKing · 24 min
Muse Wonder Full của Meta làm sáu app KingBench 4: kiểm từng app chạy được gì, điểm so với Standard Wonder, Opus 5.5, GPT-6, token và chi phí ước tính.
Thử Gemini 4 Argon: 1 triệu output token và agent chạy hàng giờ
Muhammad Farooq · Prompt Engineering · 20 min
Thử Gemini 4 Argon: continuation token cho 1 triệu output token, cách prompt output dài, chọn reasoning effort, và vì sao grader phải nằm ngoài sandbox.
Hàng trăm kết quả toán học của OpenAI và câu hỏi về mục tiêu của toán học
Károly Zsolnai-Fehér · Two Minute Papers · 9 min
Károly Zsolnai-Fehér kể hai kết quả toán học AI của OpenAI anh thích, tranh luận chứng minh không thanh lịch và lý do anh muốn model open weights.
Theo thử Gemini 4 Argon: giỏi trượt ván, dở code thật
Theo Browne · Theo - t3․gg · 38 min
Theo thử Gemini 4 Argon: giá thật sau cache, frontend, game 3D, rồi các bài audit code cho thấy tỉ lệ claim sai rất cao so với Opus, Sol và Muse.
Open model có theo kịp OpenAI và Anthropic? Distillation, compute và RL environment
Lisha Li & Nathan Lambert · a16z · 59 min
Nathan Lambert bàn khoảng cách giữa frontier lab và open model: distillation, compute, data, RL environment, RSI và kế hoạch của Trillium (video 14/10/2026).
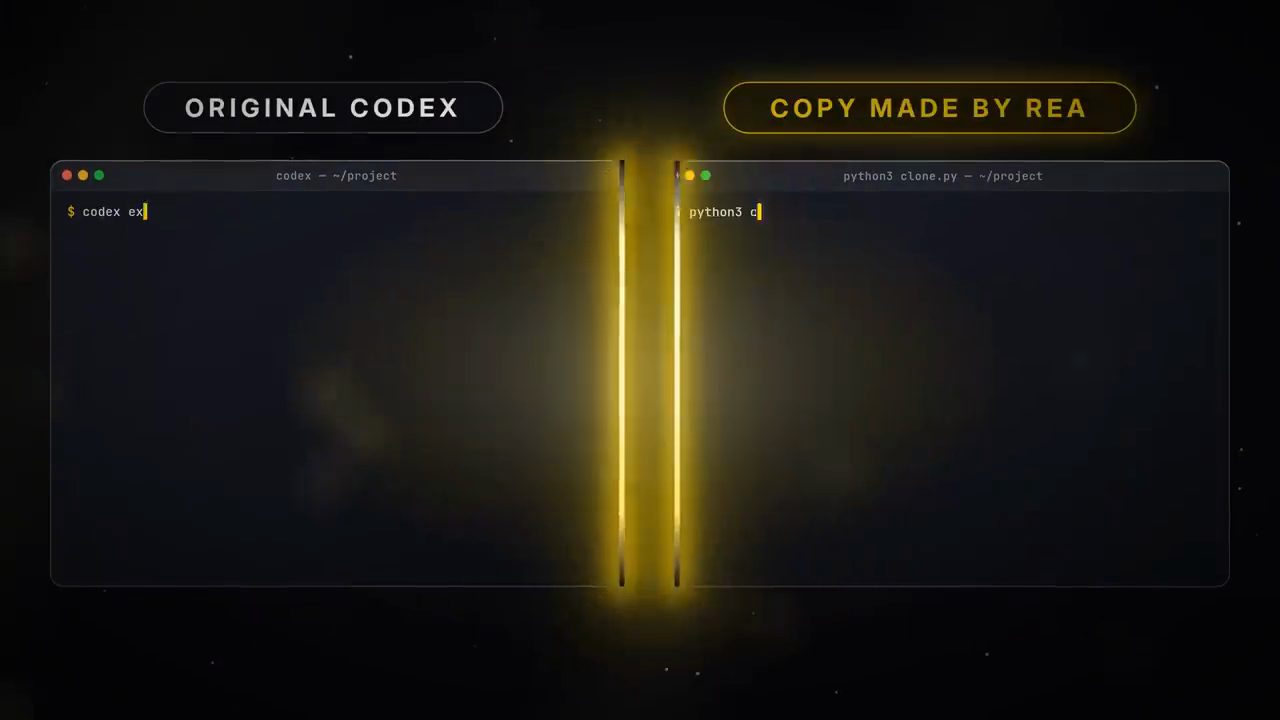
Dùng REA và Claude Code dựng lại Codex của OpenAI
SoftsWeb · SoftsWeb · 9 min
Claude Code dựng lại engine Codex chỉ từ file đã cài, chấm bằng hidden test: vòng một bỏ qua REA, vòng hai dùng REA và Ghidra đạt 416/422 check.
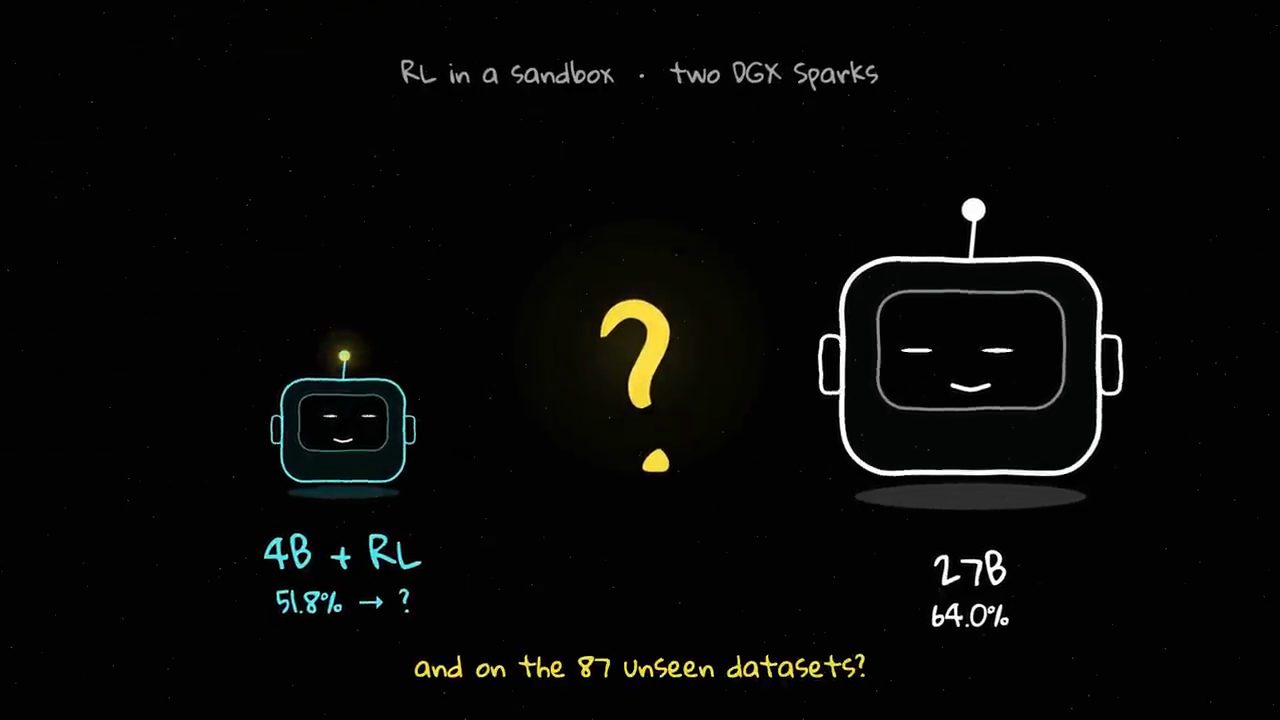
Dùng RL để Qwen 4B đuổi theo Qwen 27B
Muhammad Farooq · Prompt Engineering · 16 min
Train Qwen 3.5 4B bằng GRPO trên RL environments mở: checker chặt, chọn task ở mép năng lực, vì sao điểm chững lại, rồi distillation từ 27B.
Memory wall: vì sao LLM và AI accelerator bị nghẽn ở bộ nhớ
Kaoutar El Maghraoui · IBM Technology · 12 min
Memory wall, arithmetic intensity và roofline model: tính ridge point của B200, vì sao decode bị memory bound còn prefill compute bound, và batching giúp ra sao.
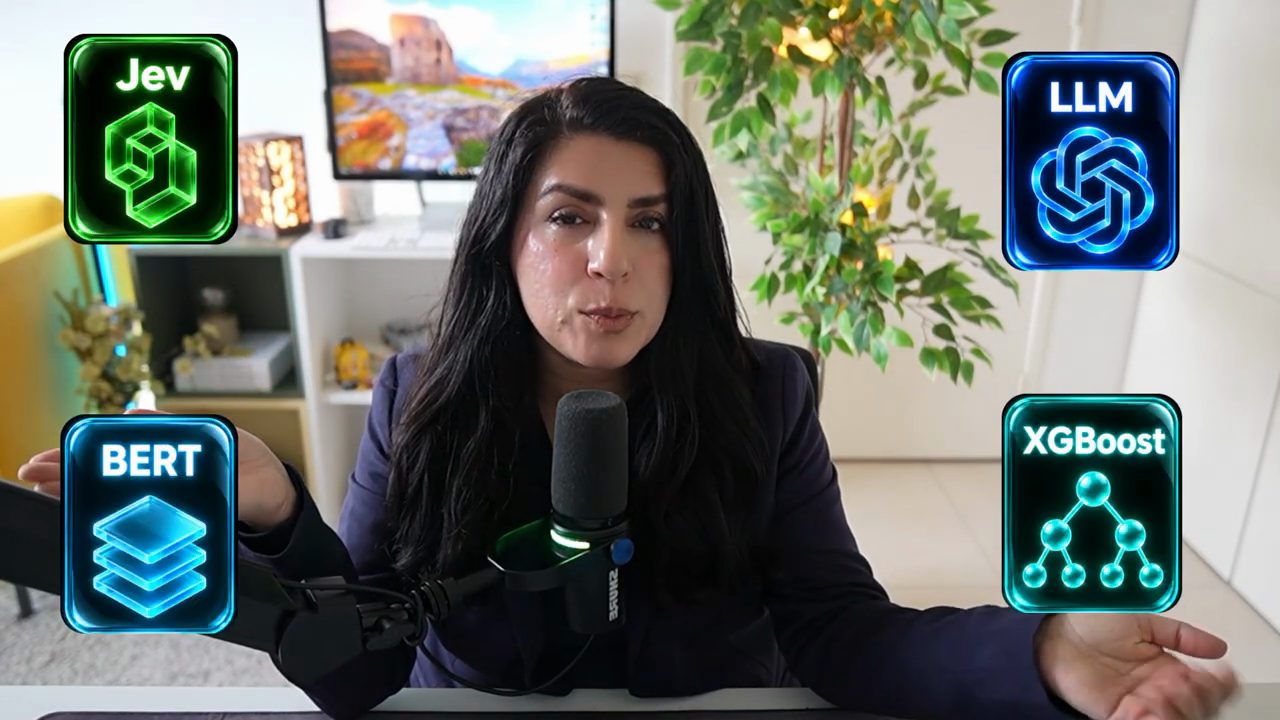
Jev, LLM, BERT và XGBoost cùng giải một bài toán phân loại ngân hàng
Maryam Miradi · Dr. Maryam Miradi · 23 min
So Jev, GPT-4.1 nano, MiniLM và XGBoost trên 120 tin nhắn BANKING77: accuracy, Macro-F1, latency, chi phí, cách từng model chạy và khi nào dùng cái nào.
Software factory thật ra là gì
Zach Lloyd · Warp · 26 min
Zach Lloyd giải thích cloud software factory: hạ tầng mở định nghĩa bằng code, factory engineering, scoring, self-improvement và benchmark trên việc thật.
Ponytail 5.0 có thật sự giải bài toán token của Claude?
Chase Hannegan · Chase AI · 17 min
Chạy lại benchmark của skill Ponytail 5, đấu với một prompt bảy chữ, kiểm code có hỏng không và vì sao Ponytail bỏ mất phần nice-to-have ở front-end.
Có nên tin ChatGPT khi hỏi về sức khoẻ: trò chuyện với người phụ trách health AI ở OpenAI
Karan Singhal & Jay Rughani · a16z · 54 min
Karan Singhal (OpenAI) kể cách OpenAI đánh giá model y tế với hàng trăm bác sĩ, xử lý bất đồng, đồng thuận y khoa và vai trò của AI giữa các lần khám.
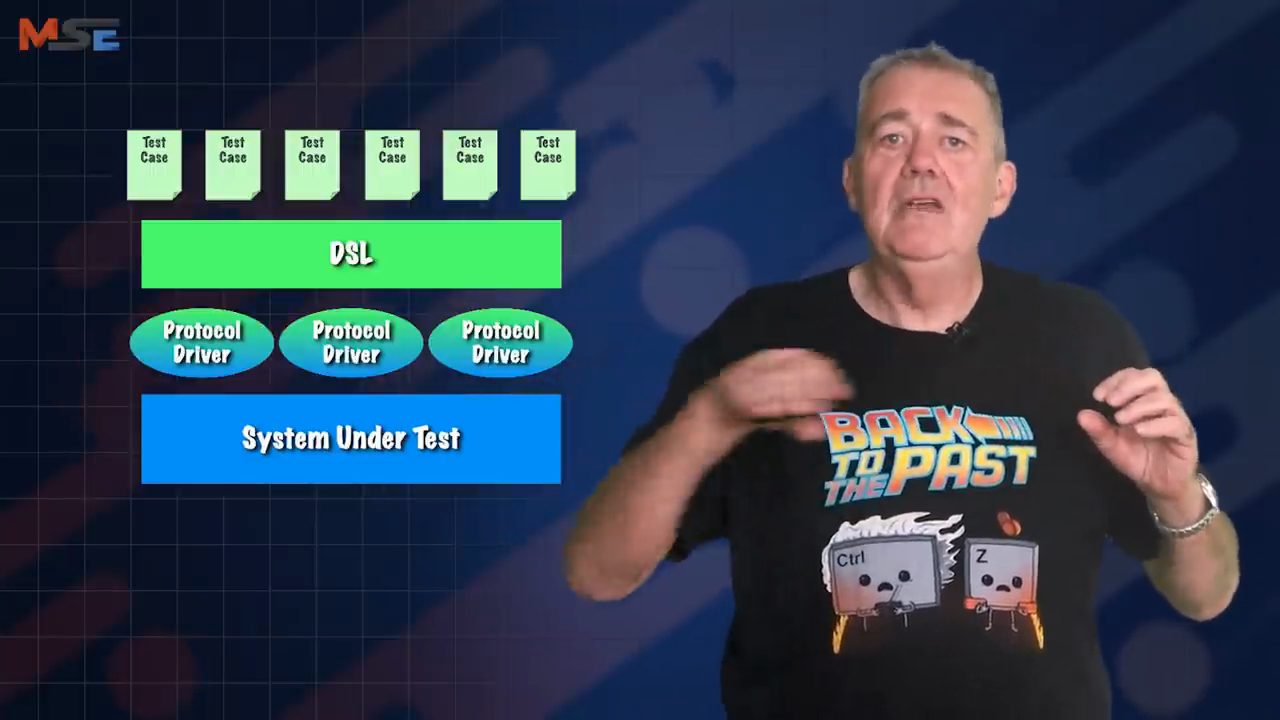
Ngành đang bắt kịp: spec phải chạy được thì code AI mới đáng tin
Dave Farley · Modern Software Engineering · 21 min
Dave Farley giải thích vì sao code do AI viết cần executable specification theo kiểu ATDD, mô hình test bốn lớp và ba quy tắc làm việc với agent.
Bài essay của Goodfire: AI có thể dễ hiểu hơn ta tưởng
Nate B Jones · AI News & Strategy Daily | Nate B Jones · 20 min
Nate B Jones đọc bài essay của Goodfire về neuron đọc hiểu được, rồi đưa bốn dự báo: bắt reward hacking, model mạnh an toàn hơn, công cụ giải thích, sửa algorithm.
Framework năm layer cho AI system design, qua ví dụ agent chăm sóc khách hàng
Aishwarya Naresh Reganti · Aish Reganti · 20 min
Framework năm layer và KARC để thiết kế một hệ thống AI agent từ scope, kiến trúc, observability, production tới tối ưu, qua ví dụ agent hỗ trợ khách hàng.
Tự chấm ChatGPT, Claude, Gemini bằng 10 việc thật của bạn
Thanh Trần · Thanh Trần - 5 Phút AI · 9 min
Ba luật tự ra đề chấm AI bằng việc thật, và bài chấm ChatGPT, Claude, Gemini bản miễn phí ở 10 việc công ty, đăng ngày 23/10/2026.
Harness² của Google: harness engineering chưa chết, chỉ lên một tầng
Kai · Kai · 22 min
Kai đọc bài báo Harness² của Google: vòng Propose, Probe, Compose, con số so với base harness trống, chi phí token, các bản sửa tìm được và Appendix H.
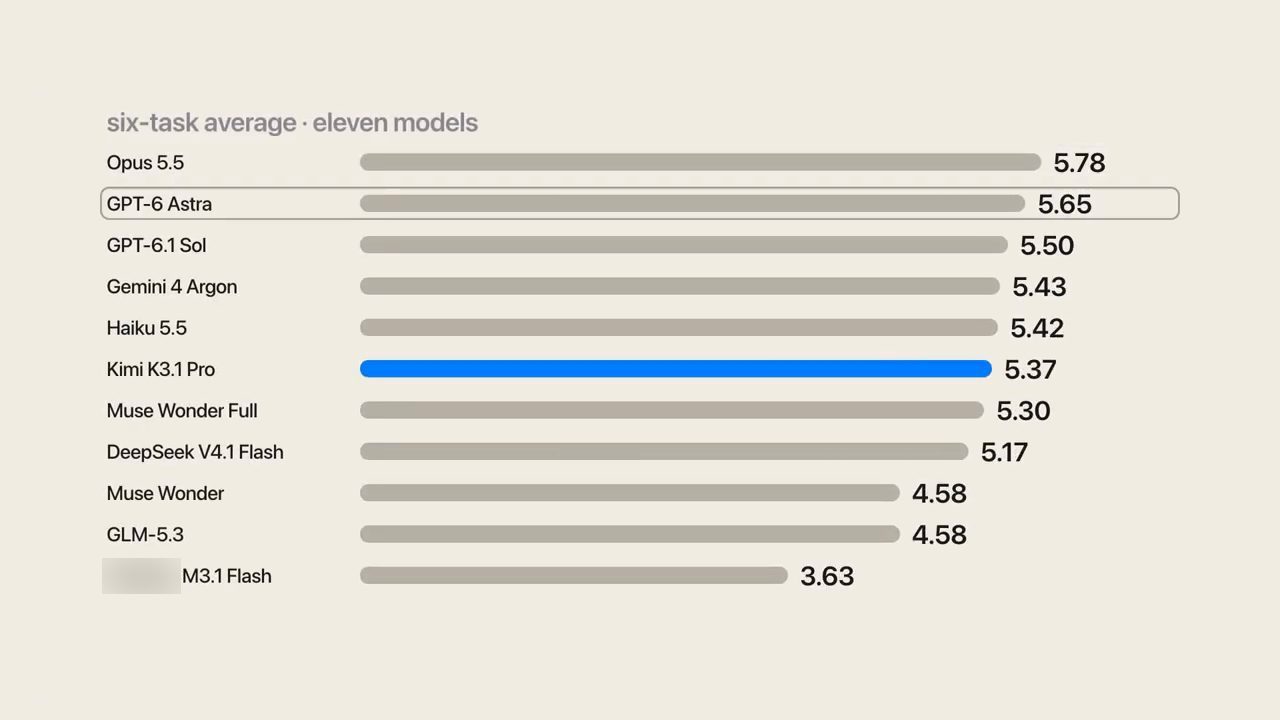
Kimi K3.1 Pro trên KingBench 4: gần bằng Opus hay không
AICodeKing · AICodeKing · 14 min
Chạy Kimi K3.1 Pro qua sáu task KingBench 4 bằng PandaCode: điểm từng project, bảng mười một model, chi phí $31.88 và open weights.
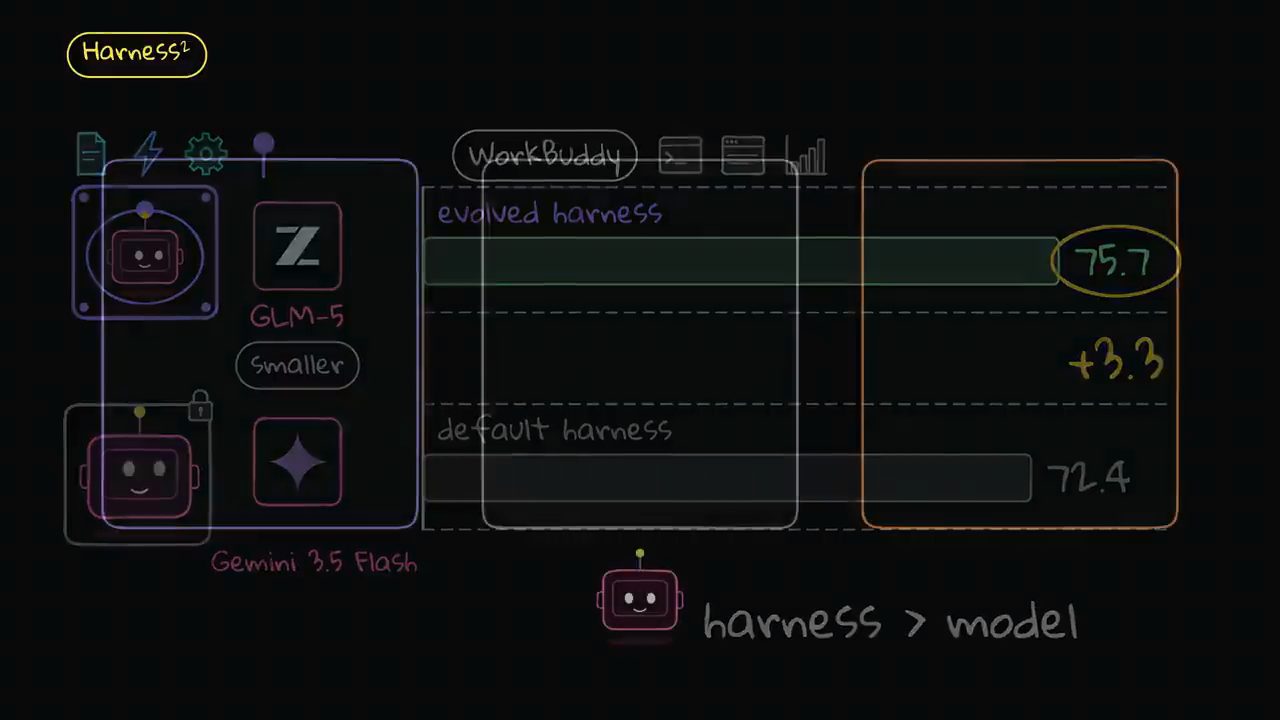
Giải thích Harness²: agent tự cải tiến harness mà không cần train
Muhammad Farooq · Prompt Engineering · 12 min
Harness² cho agent tự sửa skill, script, sub-agent và hook trong control loop qua vòng Propose, Probe, Compose, kèm kết quả và chỗ gãy.
Kimi K3.1 Pro và Opus 5.5 làm cùng 13 task dài trong Claude Code
Muhammad Farooq · Prompt Engineering · 24 min
So sánh Kimi K3.1 Pro và Opus 5.5 trên 13 task agentic dài trong cùng Claude Code: chất lượng, đường tắt, chi phí thật khi tính caching.
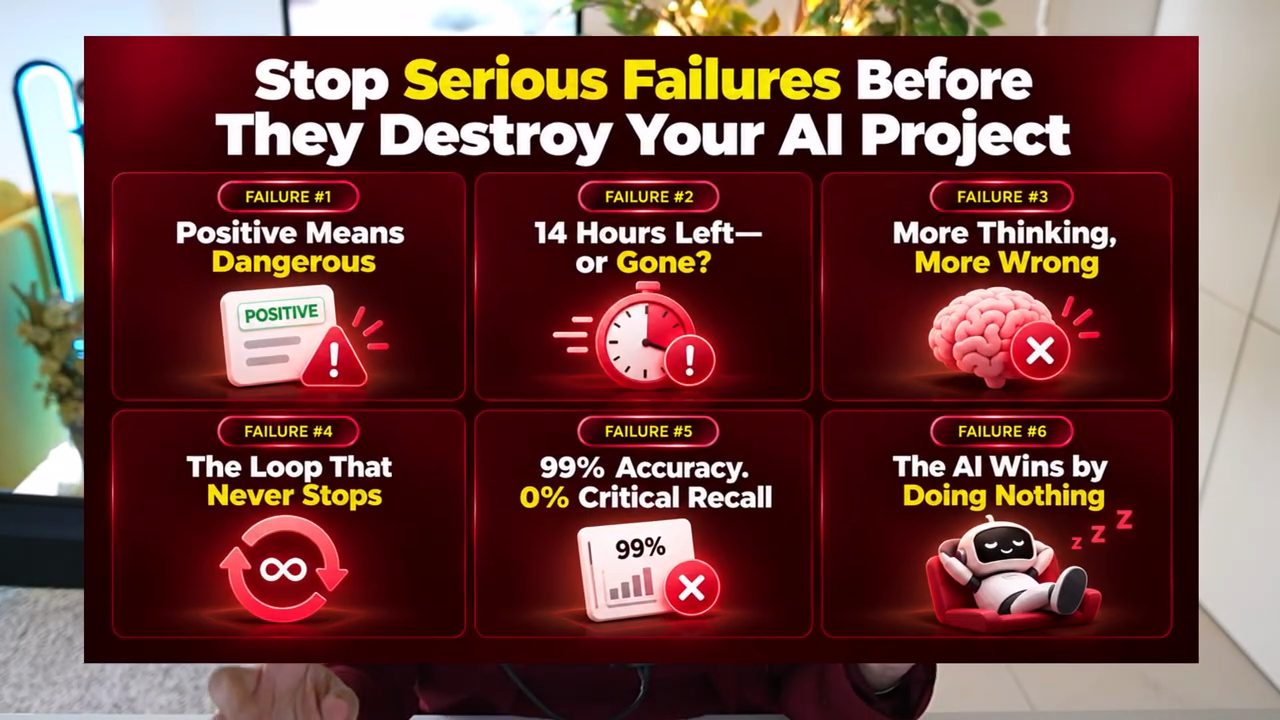
Sáu failure của production AI agent, cách sửa và checklist
Maryam Miradi · Dr. Maryam Miradi · 20 min
Sáu failure của production agent qua một hệ thống ghép thận mô phỏng: semantic, loop và evaluation engineering, kèm fix, checklist và demo Gradio.
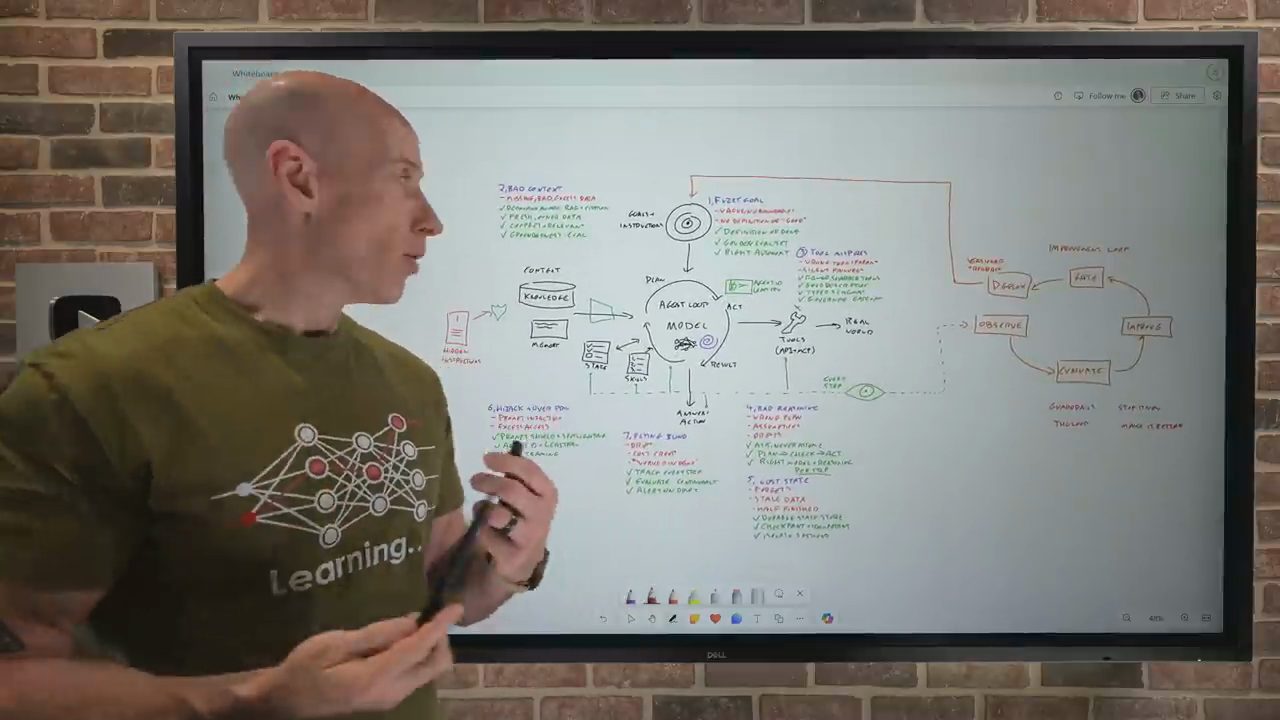
Vì sao AI agent thất bại
John Savill · John Savill's Technical Training · 43 min
Bảy lý do AI agent thất bại theo John Savill trên bảng trắng, từ fuzzy goal tới flying blind, cách sửa từng lý do và improvement loop.
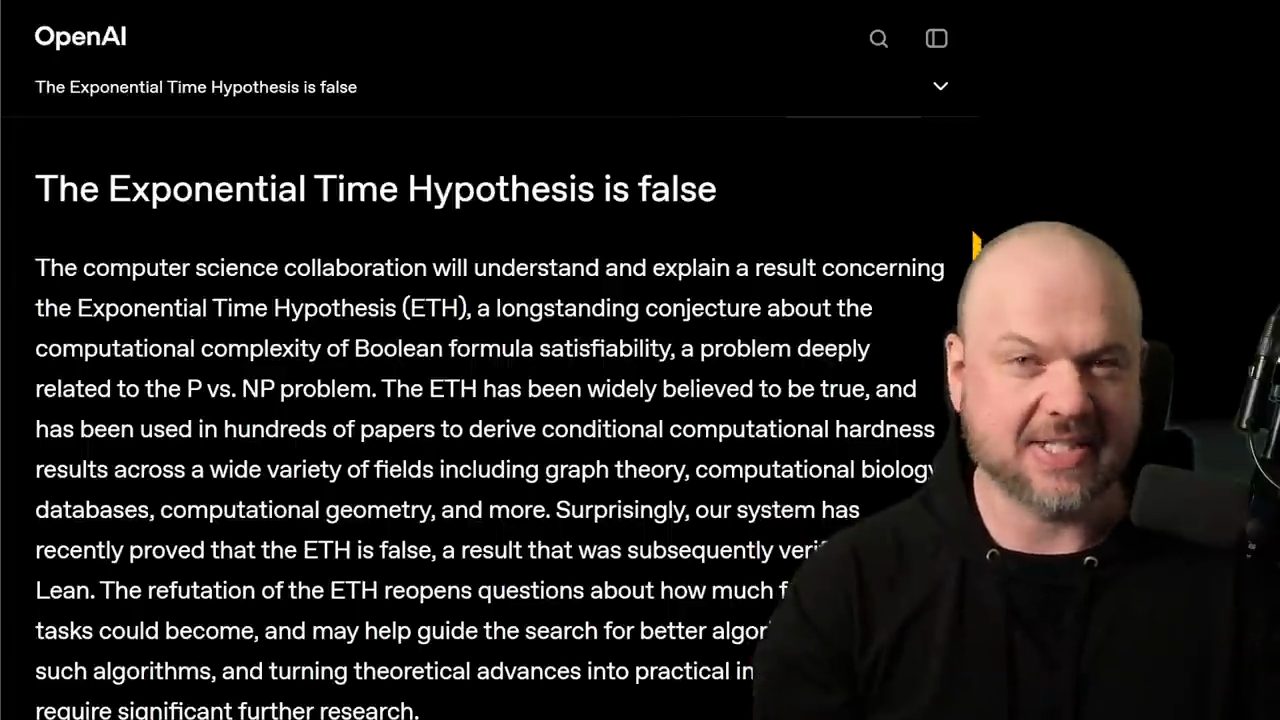
OpenAI nói AI đã bác bỏ ETH: P vs NP, mật mã và "cheat code" của vũ trụ
Wes Roth · Wes Roth · 33 min
Wes Roth giải thích tuyên bố của OpenAI rằng AI đã bác bỏ ETH, bài toán P vs NP, điều đó có thể nghĩa gì cho mật mã và tối ưu (video 27/10/2026).
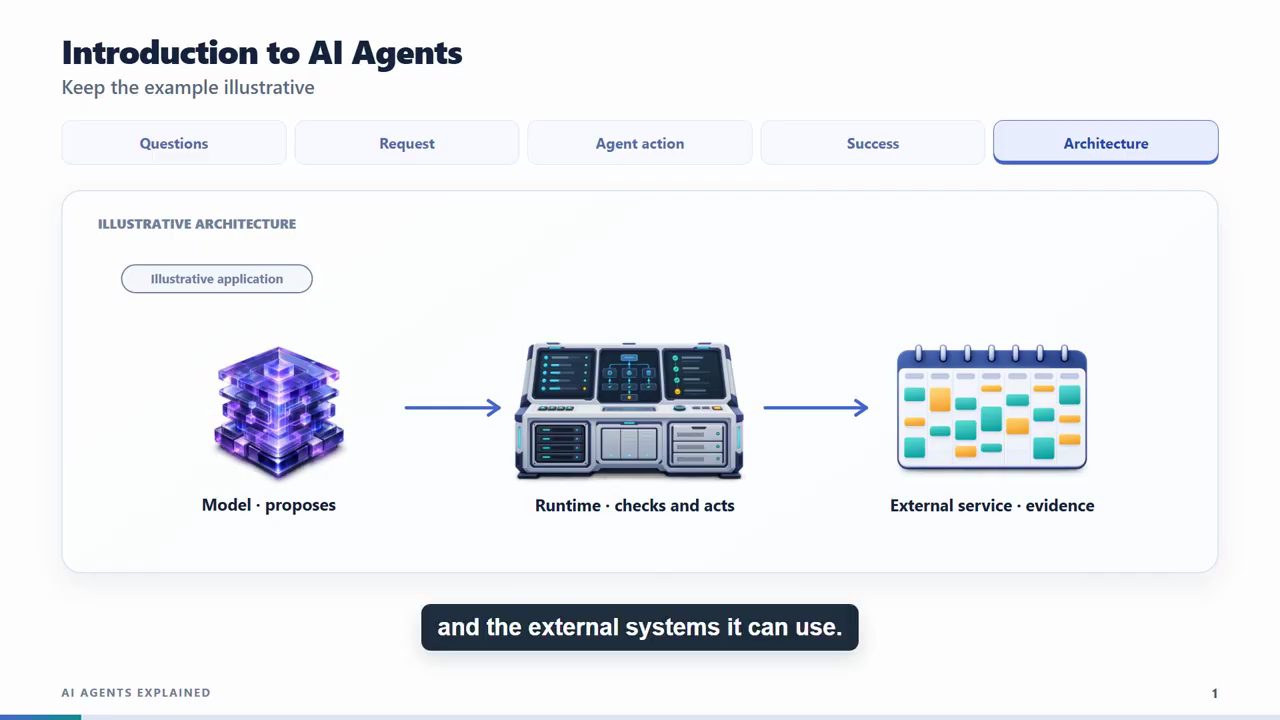
AI agent thực sự hoạt động thế nào: kiến trúc, tool, memory và MCP
Tech Architecture Explained · Tech Architecture Explained · 27 min
Theo một yêu cầu xếp lịch họp qua model, runtime, tool, memory, MCP, approval, xử lý lỗi và kiểm thử để hiểu một AI agent vận hành ra sao.
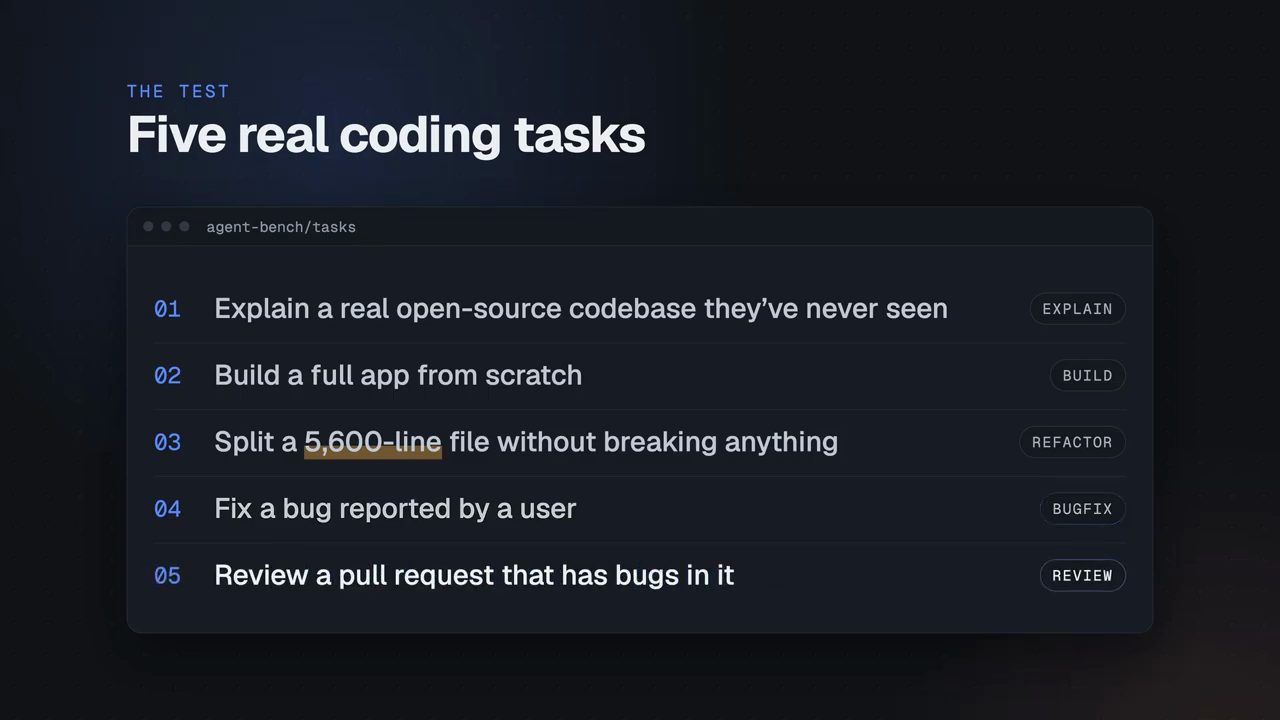
Claude Code và Codex: đo thật chi phí và hiệu năng
Nathan Sebhastian · Nathan Sebhastian · 23 min
Năm bài test code thật, ba tầng model mỗi bên, 30 lượt chạy: so thời gian, token, chi phí và cách Claude Code với Codex làm việc.
Bốn personal agent, chín task thật: ai thắng
Claire Vo · How I AI · 35 min
Claire Vo chạy Grok Bot, Dot, Muse và Claude Duet qua chín task thật, chấm điểm từng task và rút ra nên giao việc nào cho agent nào.
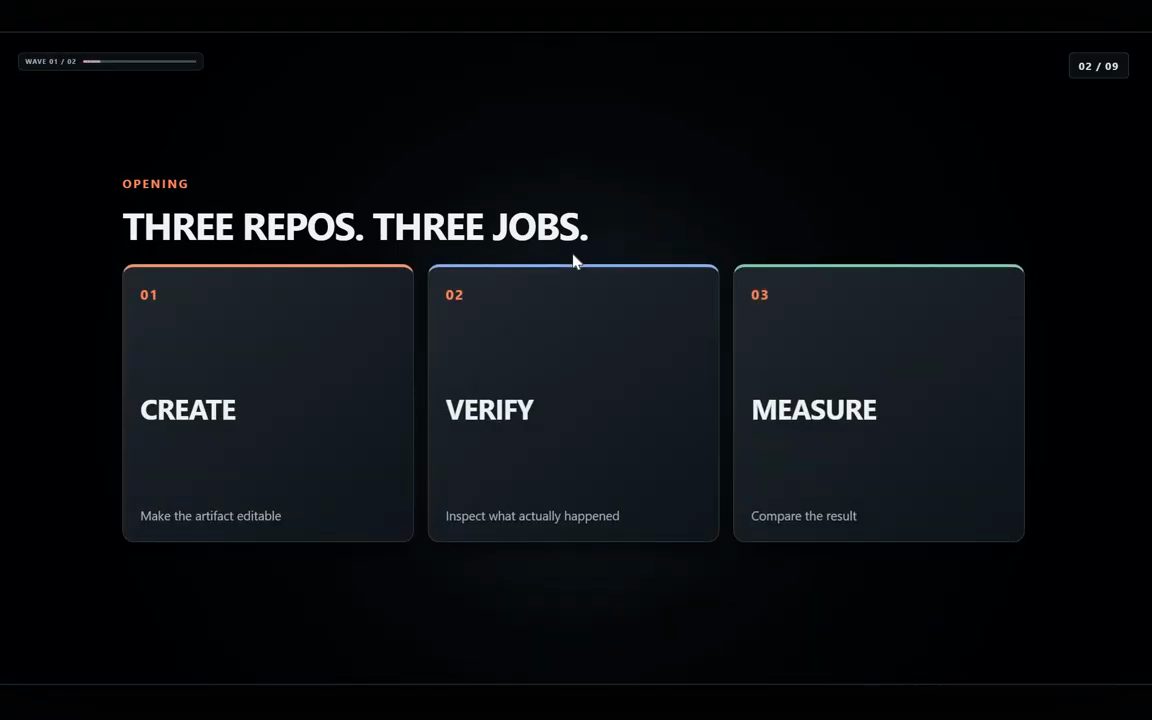
Ba repo cho coding agent: tạo, kiểm chứng và đo lường
Thetips4you · Thetips4you · 11 min
Ba repo GitHub cho Claude Code và Codex: img2threejs dựng model Three.js từ ảnh, Reticle kiểm app thật bằng verdict, Caliper đo skill bằng ablation.
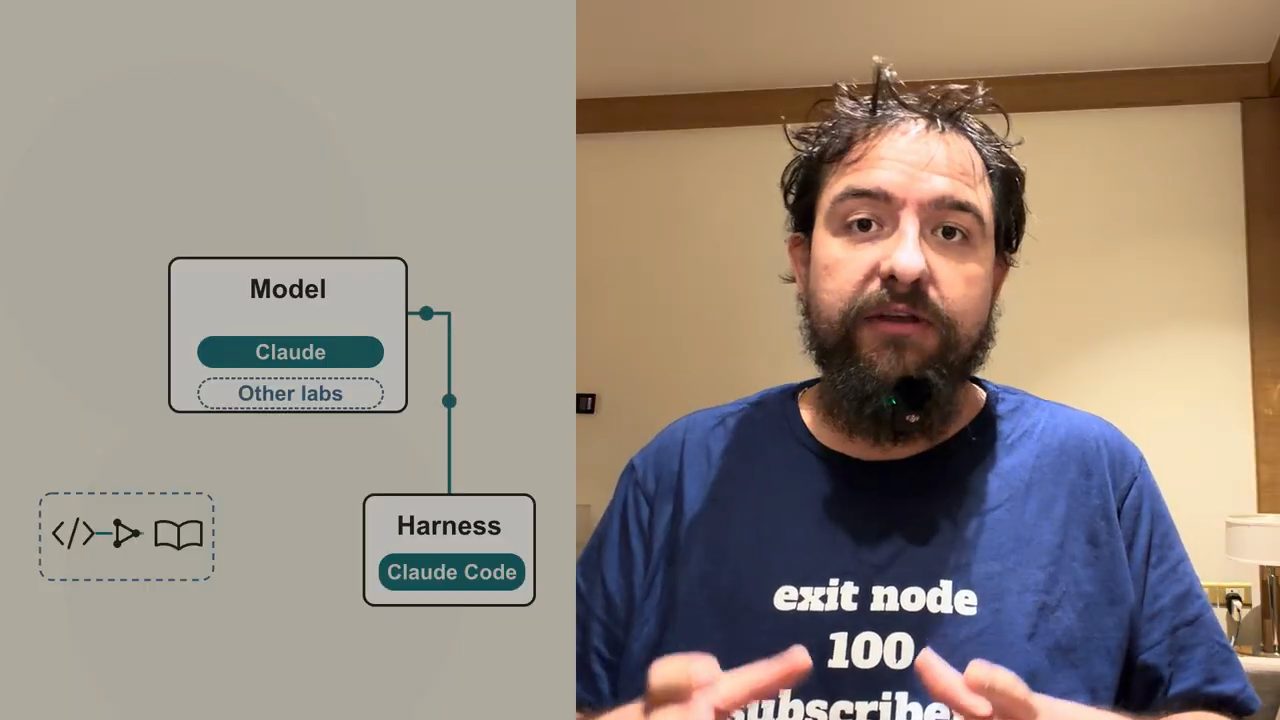
Chọn model bằng chính các PR đã merge: OMP và council of reviewers
exit node · exit node · 16 min
Vì sao chọn model quan trọng trên codebase lớn: benchmark bằng PR đã merge, council of reviewers từ ba lab, và khi nào Claude Code là đủ.
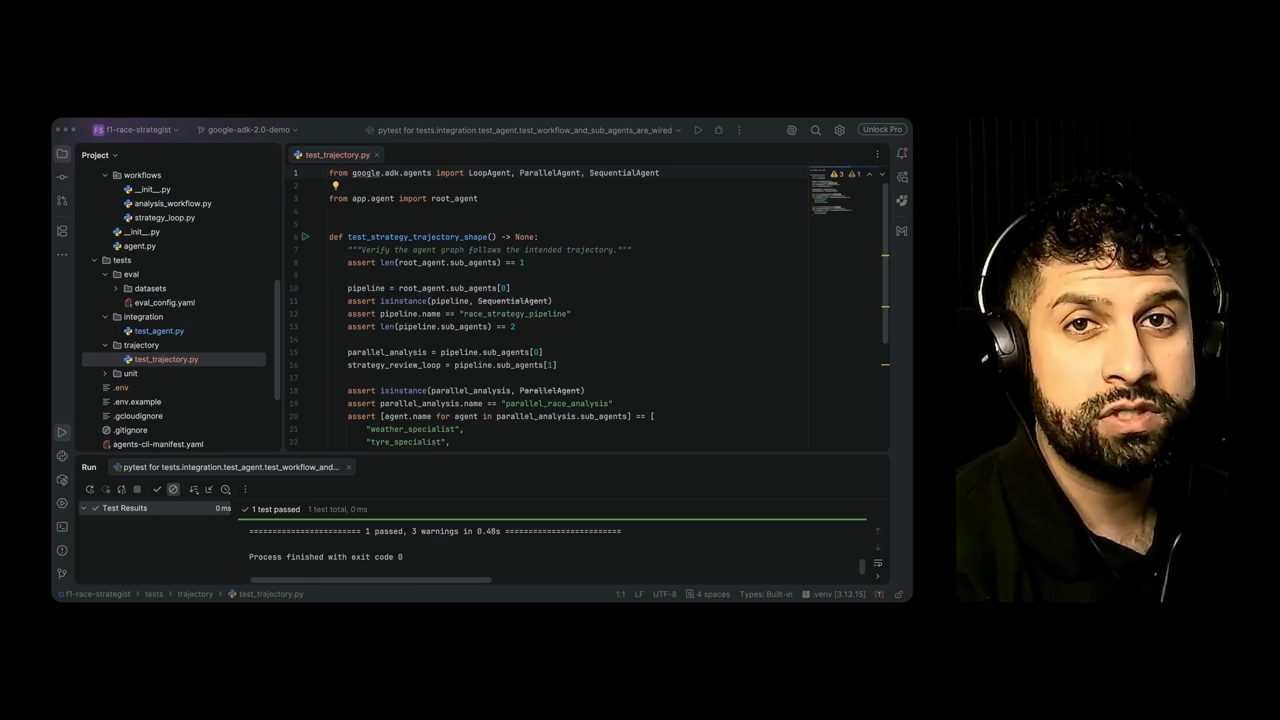
Test hệ thống multi-agent Google ADK: unit, trajectory, E2E và eval
Imran Hussain · Imran Codes · 42 min
Thêm unit, integration, trajectory, end-to-end test bằng Pytest và eval với golden dataset cho một hệ thống multi-agent Google ADK.
Khi ai cũng có thể build phần mềm
Paul Copplestone, Garry Tan, Harj Taggar & Jared Friedman · Y Combinator · 49 min
CEO Supabase Paul Copplestone cùng các host Lightcone bàn về builder, database cá nhân, thiết kế cho agent, eval và tương lai khi ai cũng build phần mềm.
Context rot: vì sao agent bỏ sót fact quan trọng
Vishesh Baghel · doodle-monster · 10 min
Vì sao prompt càng dài model càng đọc kém (context rot), nghiên cứu nói gì, ba cách đo trong app của bạn và năm cách cắt bớt context.
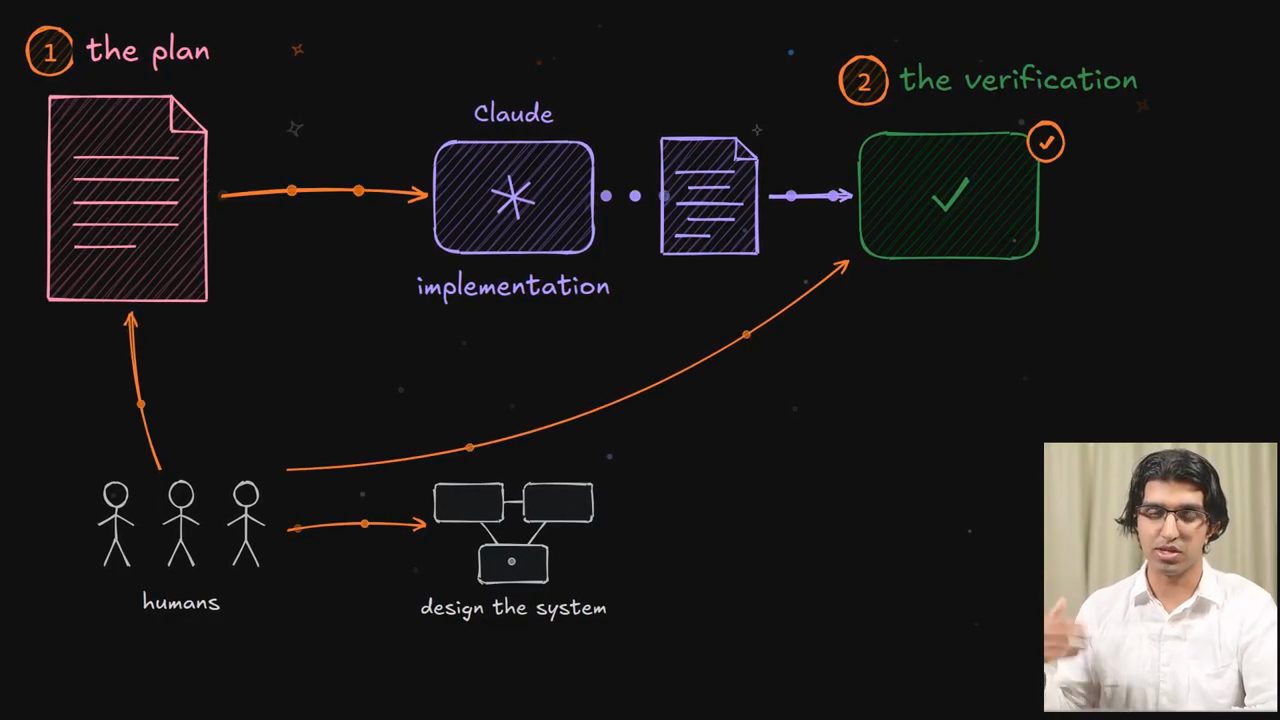
Verification là code review kiểu mới
Ray Amjad · Ray Amjad · 19 min
Vì sao xây verifier (surface, answer key, so sánh) thay cho đọc từng dòng code của agent, kèm cách xây, bảo trì và audit verifier.
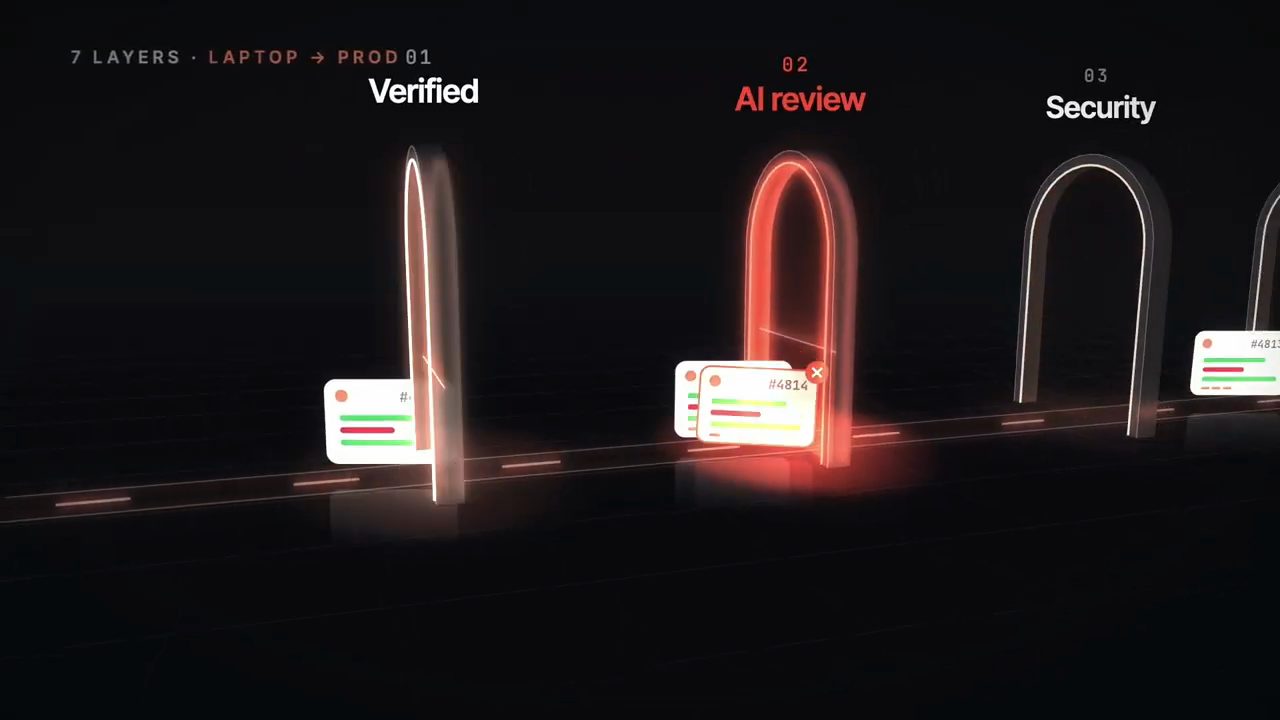
Team Claude Code review code do AI viết qua bảy layer
John Kim · John Kim · 39 min
John Kim đọc và bình bài viết của team Claude Code về bảy layer review code do agent viết, cách giữ thời gian con người và làm reviewer tốt hơn.
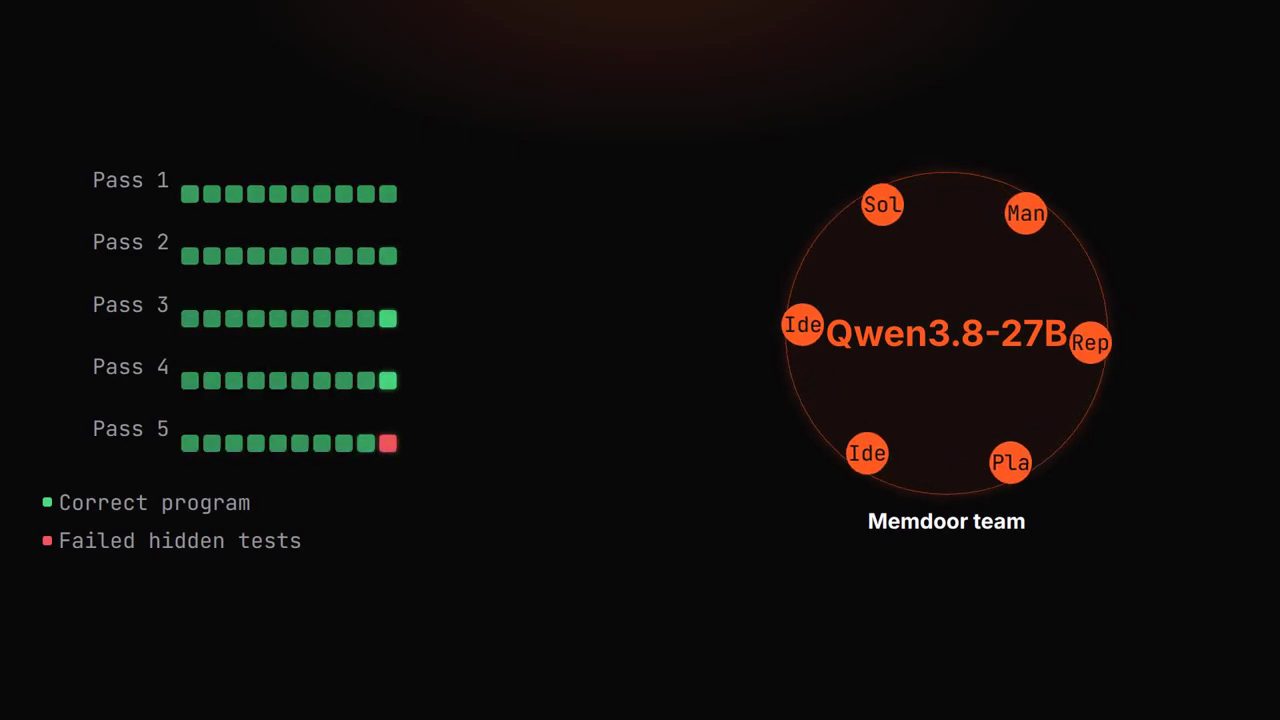
Năm agent Qwen vượt Claude trên một bài test code khó
CloudAICode · CloudAICode · 11 min
Workflow Memdoor chia một bài code khó cho năm vai cùng dùng Qwen3.8-27B, giao tiếp qua file, chấm bằng test, và giới hạn của kết quả này.
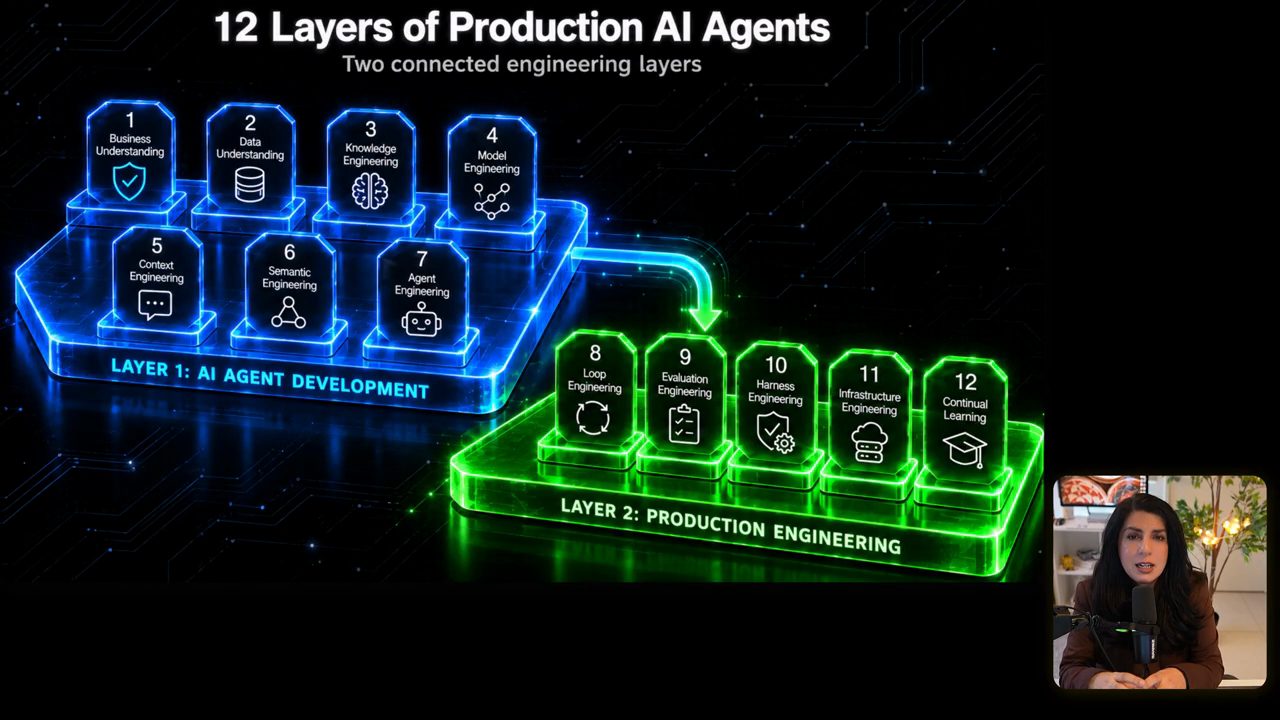
Lộ trình AI engineer 2027: code review, forward deployed engineer và 12 layer production agent
Maryam Miradi · Dr. Maryam Miradi · 23 min
Vì sao code review thành bottleneck khi AI viết code, sense of good và forward deployed engineer, rồi 12 layer production AI agent cùng công cụ cho từng layer.
Cho agent hill climb tới khi UI thật sự đẹp
Theo Browne · Theo - t3․gg · 32 min
Theo Browne dùng skill council gồm nhiều model chấm điểm ảnh UI rồi cho agent sửa tới khi đạt 9, 9.5 và 10 trên 10, kể cả chi phí và một eval MCP.
Stack hạ tầng cho software factory năm 2026
swyx & Zach Lloyd · Latent Space · 35 min
Zach Lloyd cùng swyx đi qua software factory của Warp: factory định nghĩa bằng code, trace, scorers, self-improvement, benchmark và factory stack.
Salesforce dùng Claude Code thế nào: effective output, maturity curve và skill marketplace
Muralidhar Krishnaprasad, Richard Pack & Boris Cherny · Claude · 16 min
Lãnh đạo kỹ thuật Salesforce kể cách đo ROI bằng effective output, đẩy kỹ sư lên agent maturity curve, chia sẻ skill có eval và giữ chất lượng code.
Team Claude Code review code thế nào, so với T3 Code
Theo Browne · Theo - t3․gg · 42 min
Theo đọc bài viết của Anthropic về cách team Claude Code review code khi agent viết gần hết code, và so với quy trình của T3 Code.
Fable 5.2, Gemini 4 Carbon và vòng lặp AI tự cải thiện
AI Explained · AI Explained · 32 min
Phân tích 11/2026: benchmark của Fable 5.2 và Gemini 4 Carbon, báo cáo METR về tăng tốc AI R&D, giới hạn common sense và model biết khi bị đánh giá.
Fable 5.2, Mythos 5.2 và những năng lực bị cố ý giữ lại
Wes Roth · Wes Roth · 16 min
Wes Roth đọc trang công bố và system card của Fable 5.2, Mythos 5.2, báo cáo METR, và nêu giả thuyết về giới hạn năng lực nghiên cứu AI (video 10/11/2026).
Gemini 4 Carbon: chậm, hay bịa, nhưng bất ngờ tốt ở việc bảo mật
Theo Browne · Theo - t3․gg · 30 min
Theo Browne đánh giá Gemini 4 Carbon: claim sai, tốc độ, giá và cache, UI, 3D, và vì sao nó lại xử lý tốt một báo cáo bảo mật thật trong T3 Code.
Claude API thay đổi thế nào theo từng model mới
Jake Dejno & Lucca Siaudzionis · Claude · 18 min
Jake Dejno và Lucca Siaudzionis kể Claude API đổi theo từng model ra sao: effort giữa cuộc trò chuyện, prompt caching, migration, evals, Mythos và Fable (11/2026).
Theo: Gemini 4 Carbon chậm hơn anh tưởng rất nhiều
Theo Browne · Theo - t3․gg · 20 min
Theo Browne đo lại Gemini 4 Carbon trong việc thật: chậm gấp năm lần, chờ hơn 11 giây mỗi bước, cache lỗi, và vì sao anh khuyên không dùng (11/2026).
Gemini 4 Carbon, Hydrogen và /swarm: Wes Roth thử nghiệm
Wes Roth · Wes Roth · 30 min
Wes Roth điểm qua loạt ra mắt của Google (Carbon, Hydrogen, Decision-1, AlphaProof Code, /swarm) và thử cho Gemini 4 Carbon edit video, chơi Factorio.
Vì sao công ty bạn không cần model AI đắt nhất
Nate B Jones · AI News & Strategy Daily | Nate B Jones · 20 min
Task saturation, evals và dữ liệu chi tiêu của Ramp: vì sao doanh nghiệp dùng nhiều token hơn mà hoá đơn AI đi ngang (video đăng ngày 15/11/2026).
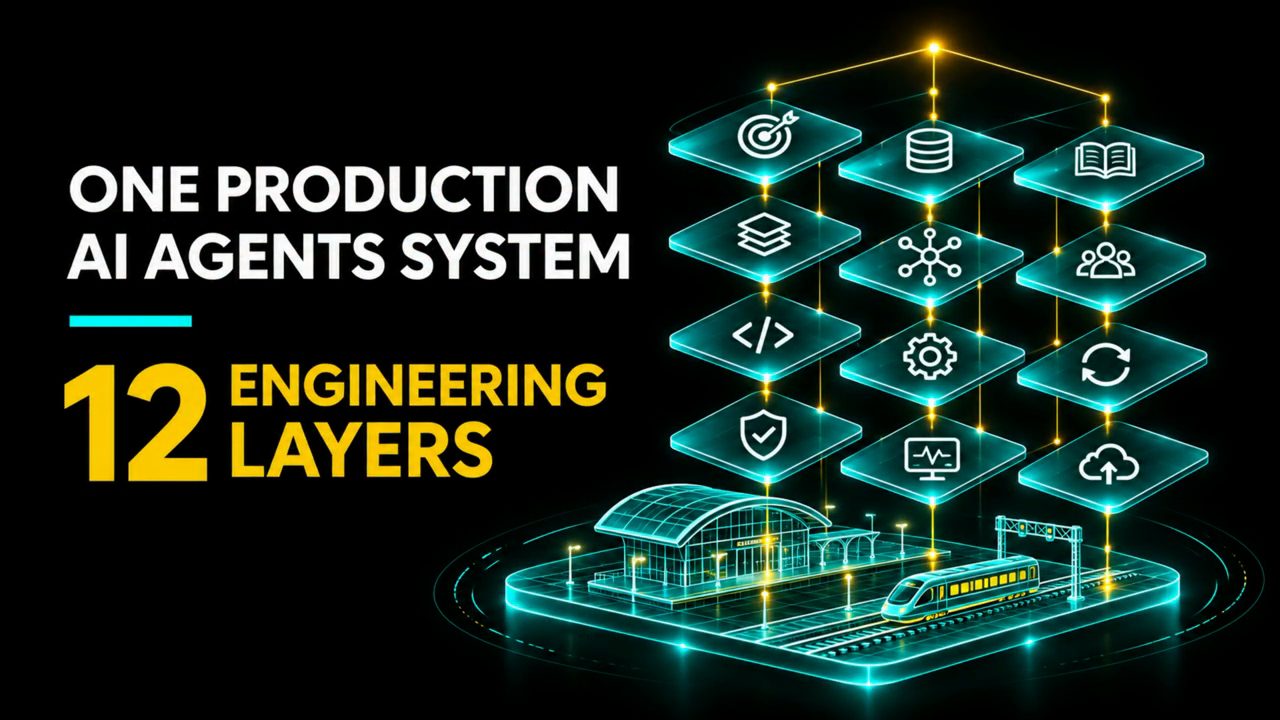
12 layer engineering cho production AI agent qua một hệ thống railway
Maryam Miradi · Dr. Maryam Miradi · 26 min
Dựng một hệ AI agent điều độ đường sắt qua 12 layer, từ business, data, knowledge tới loop, evaluation, harness và continual learning, có demo before/after.
10 skill để trở thành AI engineer
Dhaval Patel · codebasics · 32 min
Mười skill AI engineer cần theo Dhaval Patel: từ Python, LLM fundamentals, context engineering, RAG, agents, evals tới deploy, guardrails, fine-tuning và system design.
AI tự cải thiện còn bao xa: Mark Chen và John Schulman bàn về RSI
Sarah Wang, Mark Chen & John Schulman · a16z · 16 min
Mark Chen (OpenAI) và John Schulman (Thinking Machines) bàn RSI là gì, còn cách bao xa, research taste, compute và alignment (video đăng 17/11/2026).
GPT-6.2 Astra: điểm benchmark cao nhưng bị chê
Wes Roth · Wes Roth · 13 min
Wes Roth nhìn lại GPT-6.2 Astra: kết quả ARC-AGI-3, AA-Robotics, RSI Index, các lớp an toàn, những tật khi dùng và các demo 3D, game của anh.
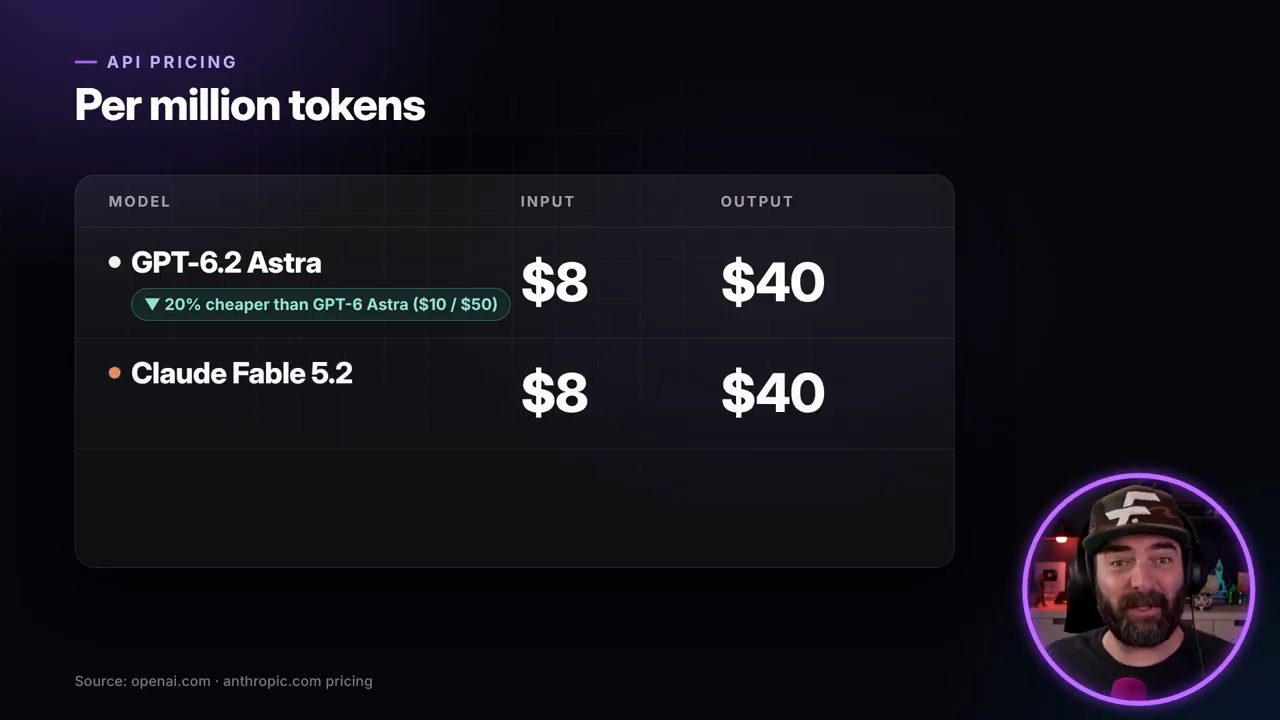
GPT-6.2 Astra ra mắt: rẻ hơn, nhưng chưa thay đổi cuộc chơi
Matt Wolfe · Matt Wolfe · 15 min
Matt Wolfe xem GPT-6.2 Astra và Sol: giá, benchmark, ý kiến người thử sớm, bài thử SVG và Megabonk, và mốc AI self-improvement của OpenAI.
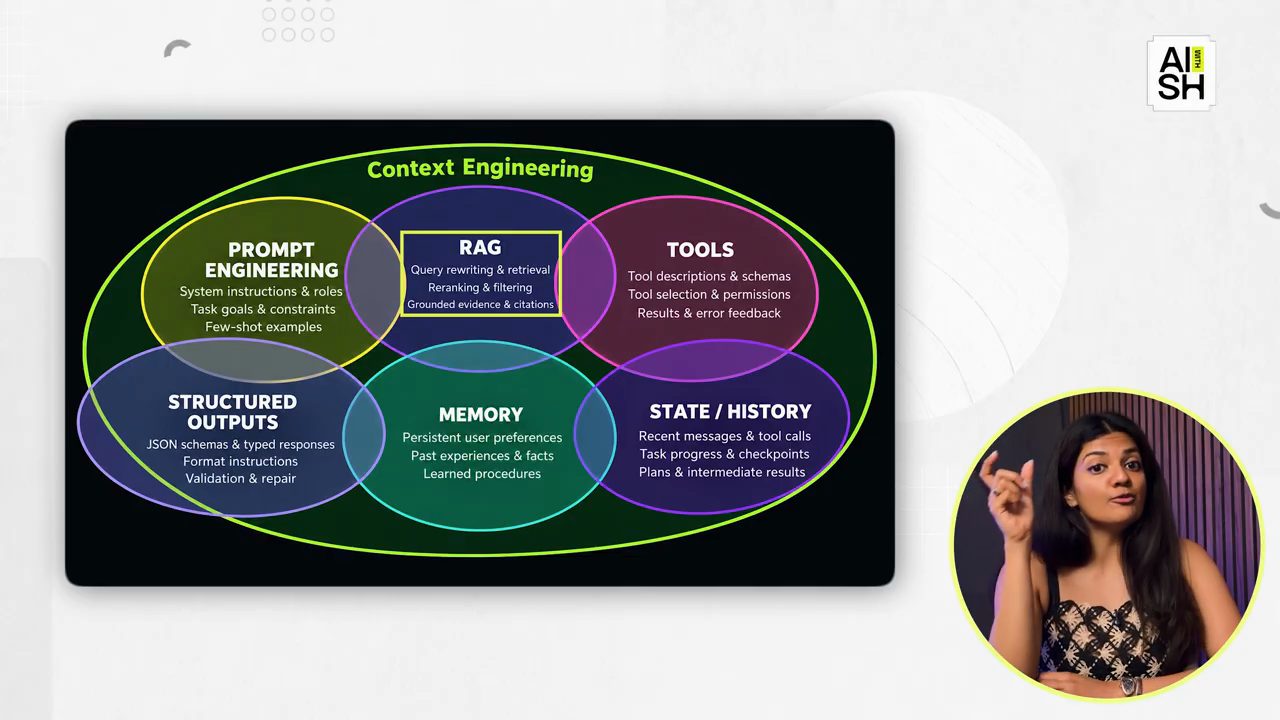
Context engineering cho trợ lý mua sắm: retrieval, hard filter và memory nhiều lượt
Aishwarya Srinivasan · Aishwarya Srinivasan · 20 min
Context engineering qua một trợ lý mua sắm: token budget, keyword, semantic và hybrid search, hard filter, memory nhiều lượt và cách đánh giá retrieval.
Vì sao Theo ghét dùng 6.2 Astra dù nó rất mạnh
Theo Browne · Theo - t3․gg · 46 min
Theo Browne giải thích vì sao anh ghét dùng 6.2 Astra để code dù benchmark rất tốt: hỏi khó hiểu, giải thích rối, chạy vòng vòng trên task dài.
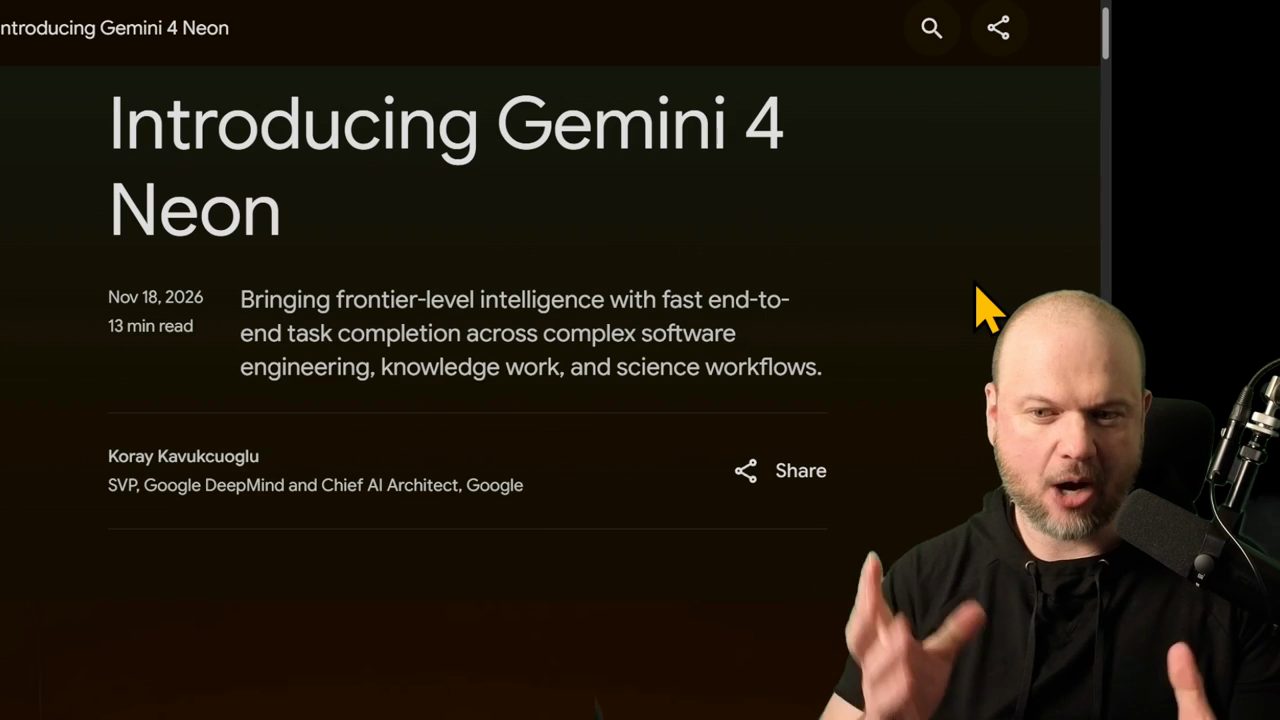
Gemini 4 Neon: nhanh hơn, rẻ hơn và các bài thử của Wes Roth
Wes Roth · Wes Roth · 14 min
Wes Roth đọc bài ra mắt Gemini 4 Neon, các benchmark, thử Neon viết bot đấu trường và kể về bài báo Digital Red Queen (video đăng ngày 19/11/2026).
Nick Bostrom: giữ khả năng chậm lại, alignment và cái giá của trì hoãn superintelligence
Nick Bostrom, Eddy Lazzarin & Elena Burger · a16z · 39 min
Nick Bostrom bàn pacing the frontier, alignment có lẽ khó hơn khi AI mạnh hơn, cái giá của trì hoãn với tuổi thọ, governance và triết học (video 19/11/2026).
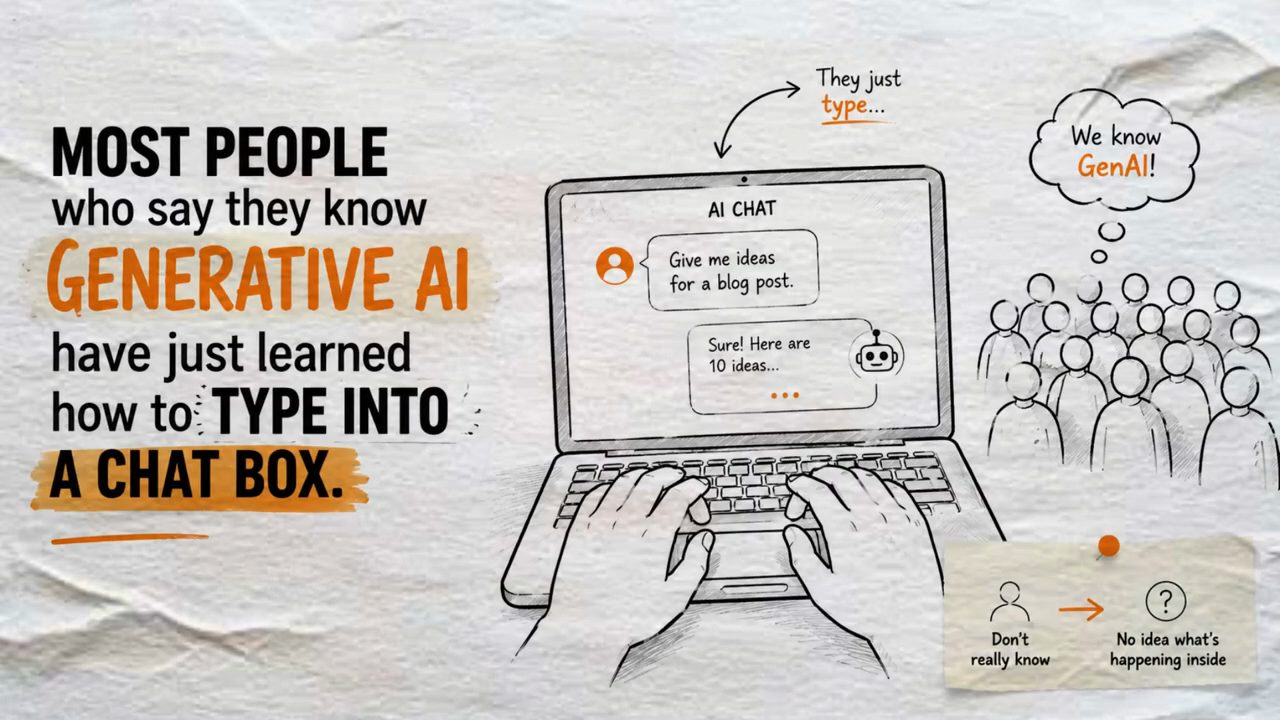
Khoá Generative AI trọn gói: từ token tới agent, eval và sự nghiệp
Tejas AI · Tejas AI · 36 min
Một lượt đi qua Gen AI: token, embedding, attention, training, sampling, RAG, agent, MCP, fine-tuning, eval, security và lộ trình chín project.
Anthropic lên sàn, GPT-6.2 Astra ra mắt và câu chuyện lớn hơn về dữ liệu, RSI và race to the top
AI Explained · AI Explained · 31 min
Phân tích 11/2026: vì sao model tốt nhất tuỳ lĩnh vực và dữ liệu, AI tăng tốc nghiên cứu AI bao nhiêu, và race to the top của Anthropic khi IPO.
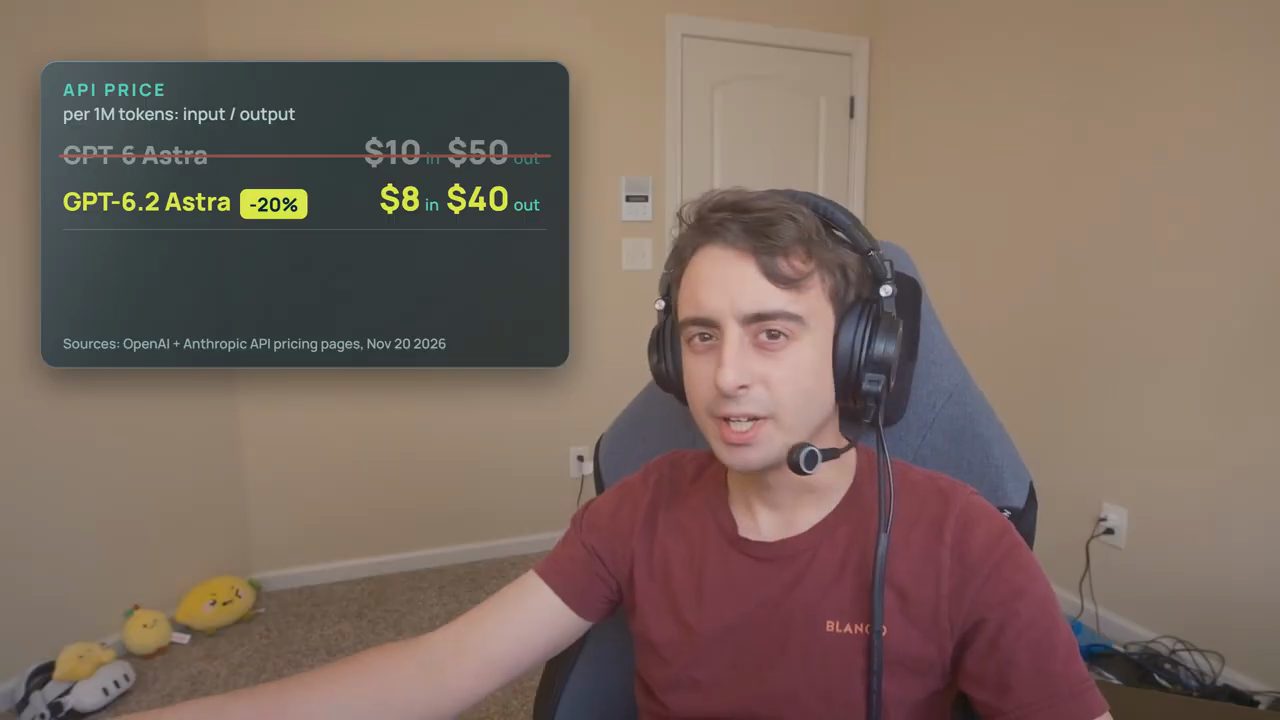
Cảm nhận của Matt về GPT-6.2 Astra: rẻ hơn, nhưng đã đủ chưa?
MattVidPro · MattVidPro · 15 min
Matt so GPT-6.2 Astra với Claude Fable 5.2 qua demo 3D, benchmark coding agent, mức effort, giá và hai bài test Blender của anh (video đăng 20/11/2026).
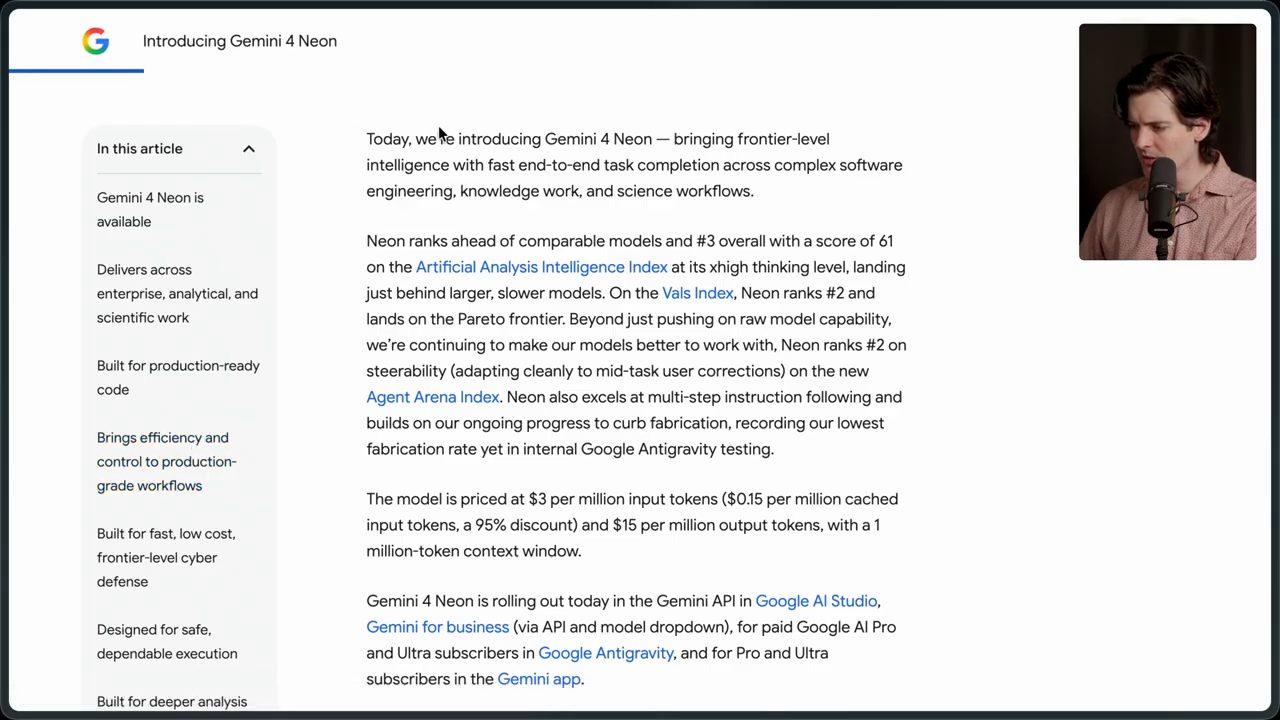
Gemini 4 Neon qua các bài test của Theo: model yêu thích mới của anh
Theo Browne · Theo - t3․gg · 32 min
Theo Browne kể các bài test thật của anh với Gemini 4 Neon (11/2026): coherency, TS Rust, viết kế hoạch, bench, 3D, và phỏng đoán vì sao model ra sớm.
Eval trong production cho hệ thống agentic AI
Nishant Gupta · Meta · 8 min
Eval cho agent phải đo hành vi cả hệ thống: scenario offline, production telemetry, human review, drift, trace và metric reliability gắn với kết quả kinh doanh.
Giả thuyết Miranda: vở musical Hamilton đã đầu độc persona eval của bạn ra sao
Jacob E. Thomas · Results Generation · 58 min
Vì sao persona eval chấm fluency không bắt được persona ghép lẫn văn hoá sai thời đại, và instrument pre-registered với nhà sử học để đo fidelity.
Đối chiếu nhiều tài liệu bằng AI để kiểm tra tuân thủ tài chính và phát hiện gian lận
Varsha Shah · Tata Consultancy Services · 19 min
Gian lận nằm giữa các tài liệu: nối payroll, thuế, mua hàng bằng graph, chấm risk score theo xác suất, chuẩn hoá giữa các jurisdiction.
Tín hiệu từ user chết ở ranh giới retrieval
Sonam Pankaj · StarlightSearch · 16 min
Vì sao tín hiệu eval chết trong dashboard, và cách dùng utility score để re-rank memory theo outcome, giúp agent tự cải tiến lúc runtime.
Continual learning cho AI agent: từ thất bại tới cải tiến bền vững
Soheil Feizi · RELAI · 22 min
Biến log và feedback production thành learning environment replay được, sửa agent ở đúng layer (model, harness, memory) mà không gây regression.
Vì sao agent bất đồng với chính nó, và nên làm gì
Diane Lin · Datadog · 26 min
Agent flip-flop là dấu hiệu của gray zone: dùng disagreement để chọn ca cho người review, rồi thêm semantic và episodic memory thay vì fine-tune.